Речевая аналитика - это программа, которая переводит записи звонков контакт-центра в текст и проверяет каждый разговор и чат по правилам компании (чек-листу), например, поздоровался ли оператор, назвал ли срок доставки или ремонта и не нагрубил ли. Без неё отдел контроля качества успевает прослушать малую часть разговоров. Директор направления клиентской поддержки ритейлера Лемана ПРО в интервью отраслевому изданию Retail.ru (июнь 2026 года, материал с пометкой «Реклама») рассказал, что в компании «свыше 400 операторов», а услышать физически успевали 1,5% диалогов. В сервисной сети по ремонту бытовой техники Ленремонт, по статье исполнителя проекта, компании Aiston, на Хабре и пресс-релизу на CNews, слушали от 5 до 10% звонков. Часть прослушивания и проверки звонков компании уже отдают программам, и одна из таких практик описана в документе, подготовленном при участии Банка России.
В сентябре 2026 года рабочая группа Банка России, Ассоциации ФинТех и Альянса в сфере ИИ подготовила Сборник лучших практик соблюдения Кодекса этики. В нём финансовые компании описывают, как выполняют Кодекс этики, рекомендации Банка России организациям финансового рынка, которые разрабатывают и применяют ИИ. Среди практик есть речевая аналитика звонков страховщика «Капитал LIFE Страхование жизни». Первой задачей системы страховщика в сборнике назван «контроль качества работы оператора при общении с клиентом, в том числе отработка возражений, соблюдение сценария диалога (скрипта)». «При этом ИИ не заменяет сотрудника контроля качества и не оценивает работу оператора. Сервис предварительно размечает и приоритизирует диалоги, а итоговая оценка осуществляется ответственными сотрудниками», - сказано сразу после перечня задач.
Так система устроена у страховщика. В других опубликованных кейсах оценки ИИ складываются в показатели самих операторов. Исполнитель проекта в Ленремонте пишет, что до внедрения «мотивация и обучение сотрудников опирались на ручные и нерепрезентативные показатели», а теперь по каждому оператору видны «все его звонки, средний балл и оценки по критериям». В Лемана ПРО у каждого оператора появился «личный кабинет с динамикой по критическим ошибкам». В таком устройстве каждая ошибочная пометка ИИ о нарушении ухудшает показатель конкретного человека.
Как проверять ИИ, сборник говорит в общем разделе об управлении рисками. Тестирование «важно проводить на данных и сценариях, максимально приближенных к фактическому контексту применения ИИ», а его завершение оформлять «отчетом с указанием примененных сценариев и наборов данных, использованных метрик, достигнутых результатов». Если организация использует ИИ-модели третьих лиц, сборник советует проверять саму ИИ-модель, запрашивая документацию, и включать в договор условия, которые позволят следить за её работой. Подрядчик речевой аналитики для контакт-центра и есть такое третье лицо.
Подрядчики обещают контакт-центру проверку каждого разговора вместо нескольких процентов. Я считаю, что такая проверка действительно нужна. В устройстве, где ИИ только размечает разговоры, как у страховщика, её польза в поиске редких нарушений, которые выборка пропускает. Там, где баллы ИИ идут в показатели, польза ещё и в показателе каждого оператора, посчитанном по всем его разговорам вместо десятка из выборки. Обещание подрядчики подкрепляют процентом точности. В пяти из десяти найденных публичных кейсов он назван, например, у ОТП Банка, по материалу разработчика системы Naumen, это «более 99%» по 7 критериям из 8 (слова руководителя отдела речевой аналитики во взыскании долгов), а у Лемана ПРО точность «превысила 90%».
Но насколько велика польза от проверки каждого разговора, становится известно, только когда качество отметок ИИ измерено по каждому критерию на данных самого контакт-центра. Для этого нужен пилот, то есть прогон системы подрядчика по всем критериям чек-листа на записях звонков контакт-центра до договора на внедрение. На пилоте важнее общего процента точности посчитать, сколько настоящих нарушений ИИ найдёт, сколько пропустит и сколько отметит по ошибке. По каждому критерию чек-листа система либо ставит отметку о нарушении, либо нет. Из отметок складываются балл разговора и показатели оператора, например доля его разговоров с отметками по критерию или средний балл, поэтому ошибка отметки становится ошибкой балла. Отметку, где контролёр нарушения не нашёл, дальше я называю пустой. Процент точности, который подрядчик называет без описания замера, для сравнения подрядчиков между собой не годится. А решение о премии или взыскании оператора, даже если к нему привёл показатель из отметок ИИ, должно опираться на запись разговора, которую проверил человек.
Чего не видит выборочная проверка звонков и зачем контакт-центру проверять каждый диалог
Зарубежный разработчик системы контроля качества звонков Voxjar, сторонник проверки всех звонков, в статье августа 2026 года считает, что несколько сотен случайных звонков в месяц показывают средний балл всей команды с погрешностью около одного пункта по 100-балльной шкале. Расчёт исходит из того, что оценки отдельных звонков разбросаны вокруг среднего примерно на 12 баллов, и Voxjar прямо называет эту величину допущением. Чтобы знать средний балл команды, выборки хватает.
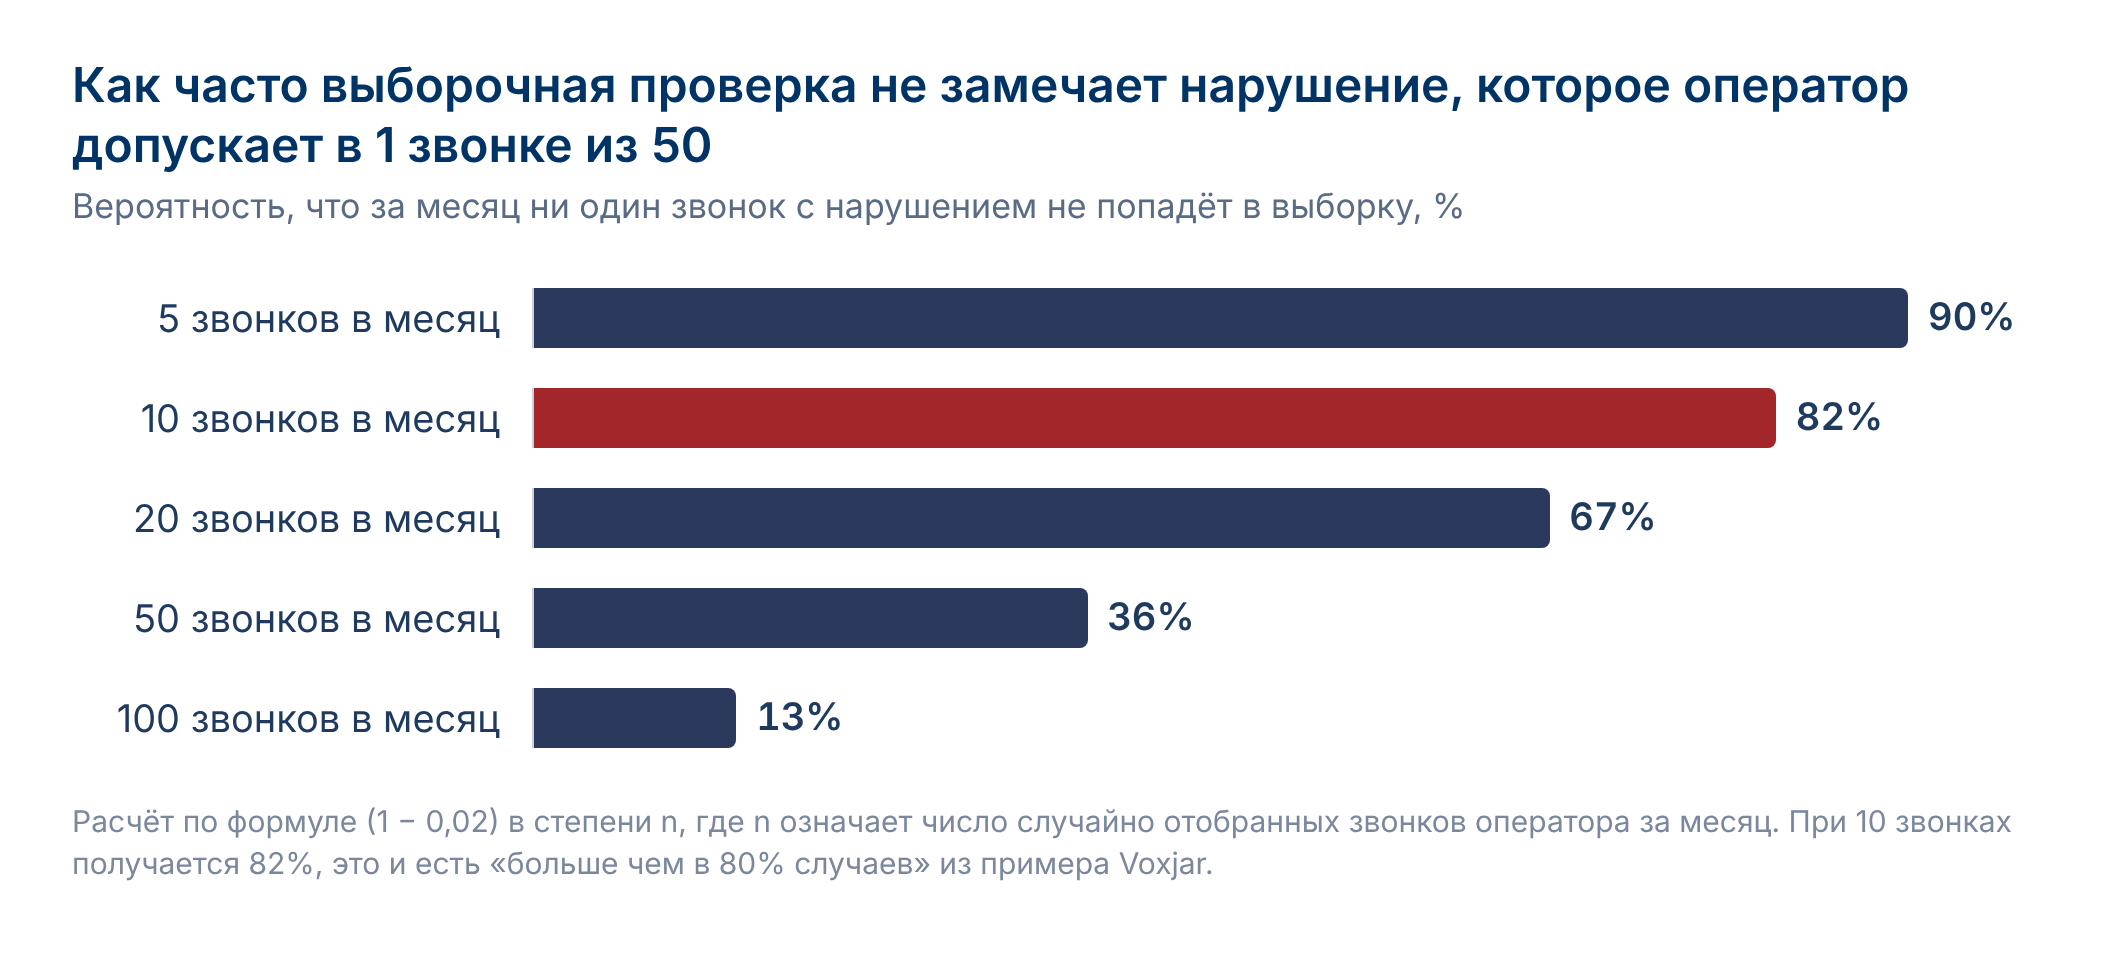
Хуже выборка справляется с двумя задачами. Первая задача состоит в поиске редких нарушений. Если оператор нарушает правило в 1 звонке из 50, а проверяют 10 его звонков в месяц, то больше чем в 80% случаев нарушение в выборку не попадёт. Случайная выборка находит ровно такую долю нарушений, какую долю звонков она проверила. Отбор звонков по признакам риска работает лучше, но помогает он, по словам Voxjar, только против рисков, которые уже подозревают. Вторая задача касается выводов об отдельном операторе. По той же статье, выборка не скажет, стал ли конкретный оператор работать лучше в этом месяце.
Есть у проверки каждого разговора и польза другого рода, например оповещения о срочных случаях. В Лемана ПРО, по тому же интервью, после угроз клиента оператору «через минуту алерт ушел руководителю смены». Но для оценки самих операторов всё решает то, насколько верно ИИ ставит отметки.
Почему процент точности ИИ-оценки нельзя сравнить между подрядчиками речевой аналитики
Ниже публичные российские кейсы речевой аналитики, которые удалось найти к ноябрю 2026 года. Все числа в них опубликовали сами компании, разработчики систем или исполнители проектов, независимой проверки нет.
| Компания | Разработчик системы | Охват по публикации | Что заявлено о точности и что ею мерили | Источник |
|---|---|---|---|---|
| ОТП Банк | Naumen | 100% диалогов | «более 99%» по 7 критериям из 8, точность оценки разговоров | Naumen, март 2026 года |
| Лемана ПРО, ритейл | 3iTech | 100% профильных звонков (раньше 1,5%) | «превысила 90%», точность оценки разговоров | Retail.ru, июнь 2026 года, реклама |
| Prime, агентство недвижимости (отдел продаж) | автор колонки на ComNews, разработчик системы | все 100% звонков | «больше 90%», заявление автора колонки о точности его системы оценки звонков | ComNews, декабрь 2024 года |
| ПЭК, логистика (пилот) | BSS | более 1,1 тыс. аудиозаписей | «превысила 92%», точность распознавания речи | BSS, апрель 2025 года |
| МТС | MTS AI | в планах более 300 тыс. обращений в день | 85%, точность определения тем обращений | MTS AI, 2024 год |
| Ленремонт, ремонт бытовой техники | Aiston | 99% разговоров | не названа, по каждому оператору считается средний балл | Хабр, ноябрь 2025 года |
| Росгосстрах | собственная разработка | 100% входящих звонков | не названа, система ищет критически важные обращения | CNews, июнь 2026 года |
| ВТБ | не назван | все звонки и чаты | не названа | ComNews, март 2024 года |
| Газпромбанк | BSS | не назван, система распределяет диалоги на ручную проверку | не названа | ComNews, март 2025 года |
| МКБ | ЦРТ | 78% обращений на старте | не названа | CNews, 2021 год |
Точность названа в 5 кейсах из 10, и меряет она разное. У ОТП Банка, Лемана ПРО и Prime это точность оценки разговоров, у ПЭК точность распознавания речи, у МТС точность определения тем обращений. С чьими оценками сравнивали и по каким критериям, не сказано ни в одном из 5 случаев. Число проверенных записей названо только у ПЭК. У ОТП Банка «более 99%» относится к 7 критериям из 8, сами критерии в публикации не названы.
Раз проценты меряют разное и неизвестно, с чьими оценками их сравнивали, сравнивать подрядчиков можно только на одних и тех же данных. Но и на одних данных общий процент совпадений может спрятать пропуски. Программа, которая никогда не отмечает нарушение, встречающееся в 1 разговоре из 100, совпадёт с контролёром в 99 разговорах из 100 (подробнее на примере срочных заявок в статье о выборе ИИ для классификации обращений). Поэтому найденные и пропущенные нарушения считают отдельно.
Сколько нарушений находили и до внедрения, и после, опубликовано только в одном из найденных кейсов, у Ленремонта. Через линию там проходит около 18 тысяч разговоров в день. По статье Aiston, отдел контроля качества слушал «рандомно около 10% звонков», по пресс-релизу «не более 5-10%», то есть от 900 до 1 800 звонков в день, и находил ошибки операторов «примерно в 10% случаев». После внедрения анализируется 99% разговоров, а число выявляемых проблемных звонков выросло «с 90 до 500 случаев в день», в 5,6 раза. Если считать в долях, находок стало меньше. 90 находок из 900-1 800 прослушанных звонков составляют 5-10% прослушанных, а 500 находок при потоке, который пресс-релиз называет превышающим 18 тысяч диалогов в сутки, не больше 2,8% всех звонков. Доля звонков с находками стала ниже в 1,8-3,6 раза, а поскольку 2,8% здесь верхняя граница, разница может быть и больше. Между собой цифры двух публикаций тоже не сходятся (при 1 800 прослушанных звонках и ошибках в 10% из них находок было бы 180 в день, а опубликовано 90). Почему доля упала, из публикаций не понять. Возможно, изменилось само понятие нарушения (по словам исполнителя, из исходного списка критериев в оценке реально использовались лишь 3-4), возможно, прежние ручные оценки «могли быть субъективными», возможно, система пропускает нарушения. Различить эти объяснения можно только сравнением отметок системы с проверенными оценками контролёров на одних и тех же звонках.
Что считать на пилоте речевой аналитики вместо процента точности
Как считать найденные и пропущенные нарушения и пустые отметки, хорошо видно на примере из статьи на Хабре октября 2026 года о том, почему сервис речевой аналитики может правильно распознать разговор и неправильно его оценить. Статья не независимая (в тексте автор ссылается на сайт разработчика речевой аналитики DEERAY), числа в примере условные. Пусть в проверочном наборе, то есть среди разговоров, на которых проверяют систему, 100 содержат нарушение стандарта. Система отметила как подозрительные 90 разговоров из всего набора, и нарушение действительно было в 70 из них. Значит, система нашла 70% нарушений, а подтвердились 77,8% её отметок. «Но фактически 30% нарушений пропущены, а часть сотрудников получила ложные замечания», - пишет автор. Он советует «отдельно проверять критические критерии, где ошибка алгоритма может привести к несправедливой оценке человека». Какие критерии считать критическими и что делать с оценкой разговора при их нарушении, решает компания. В Лемана ПРО, например, при настройке чек-листов отдельно решали, при каких условиях критическая ошибка обнуляет всю оценку звонка.
Среди показателей качества системы «Капитал LIFE» в сборнике названы «полнота выявления негативных обращений и доля ложных срабатываний». Для оценки операторов похожие показатели стоит считать по каждому критерию. Полнота показывает, какую долю настоящих нарушений по критерию система нашла.
Полнота = найденные нарушения / все настоящие нарушения
С ошибочными отметками связаны две разные доли. Доля пустых отметок показывает, какая часть отметок в очереди контролёра оказалась без нарушения.
Доля пустых отметок = пустые отметки / все отметки
Доля ложных тревог показывает, какую часть разговоров без нарушения система отметила по ошибке.
Доля ложных тревог = разговоры без нарушения, отмеченные по ошибке / все разговоры без нарушения
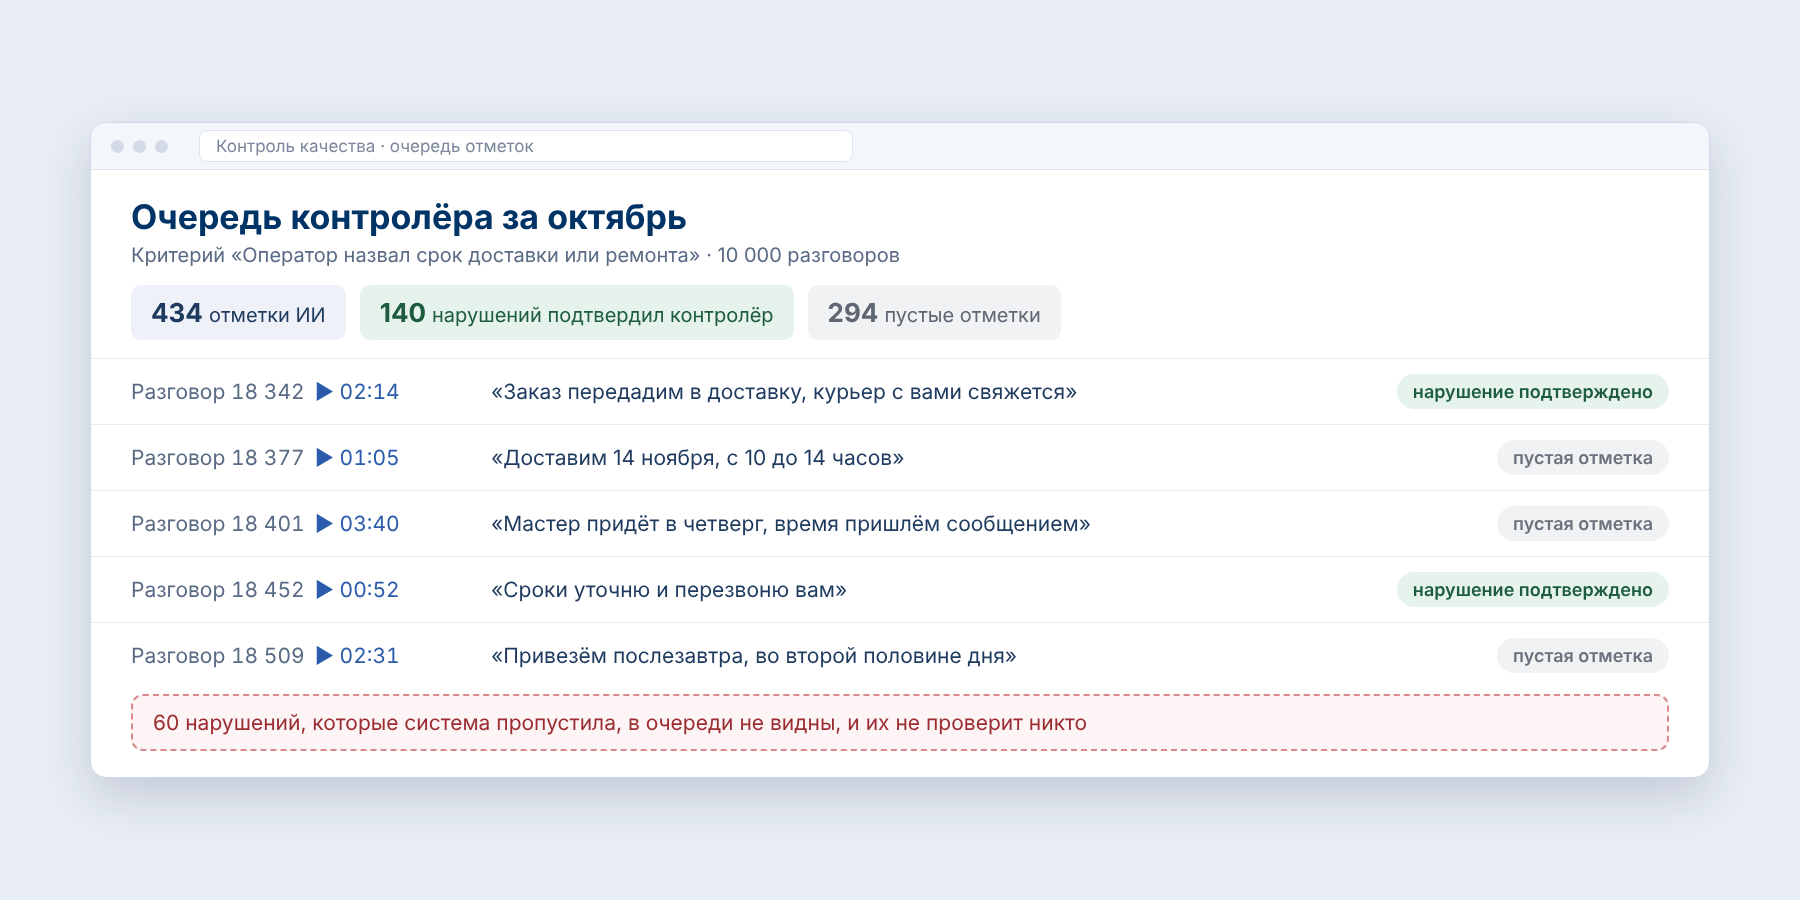
Как эти доли связаны, видно на условном примере. Допустим, в контакт-центре 10 000 разговоров в месяц, система находит 70% нарушений (как в примере с Хабра) и по ошибке отмечает 3% разговоров без нарушения (это моё допущение). Частота нарушения 2% взята из примера Voxjar про нарушение в 1 звонке из 50. Тогда нарушений за месяц 200 (2% от 10 000), система находит 200 × 70% = 140 из них и пропускает 60, а из 9 800 разговоров без нарушения по ошибке отмечает 9 800 × 3% = 294, и в очереди контролёра оказывается 140 + 294 = 434 отметки, из которых пустые 294 / 434, примерно 2/3.
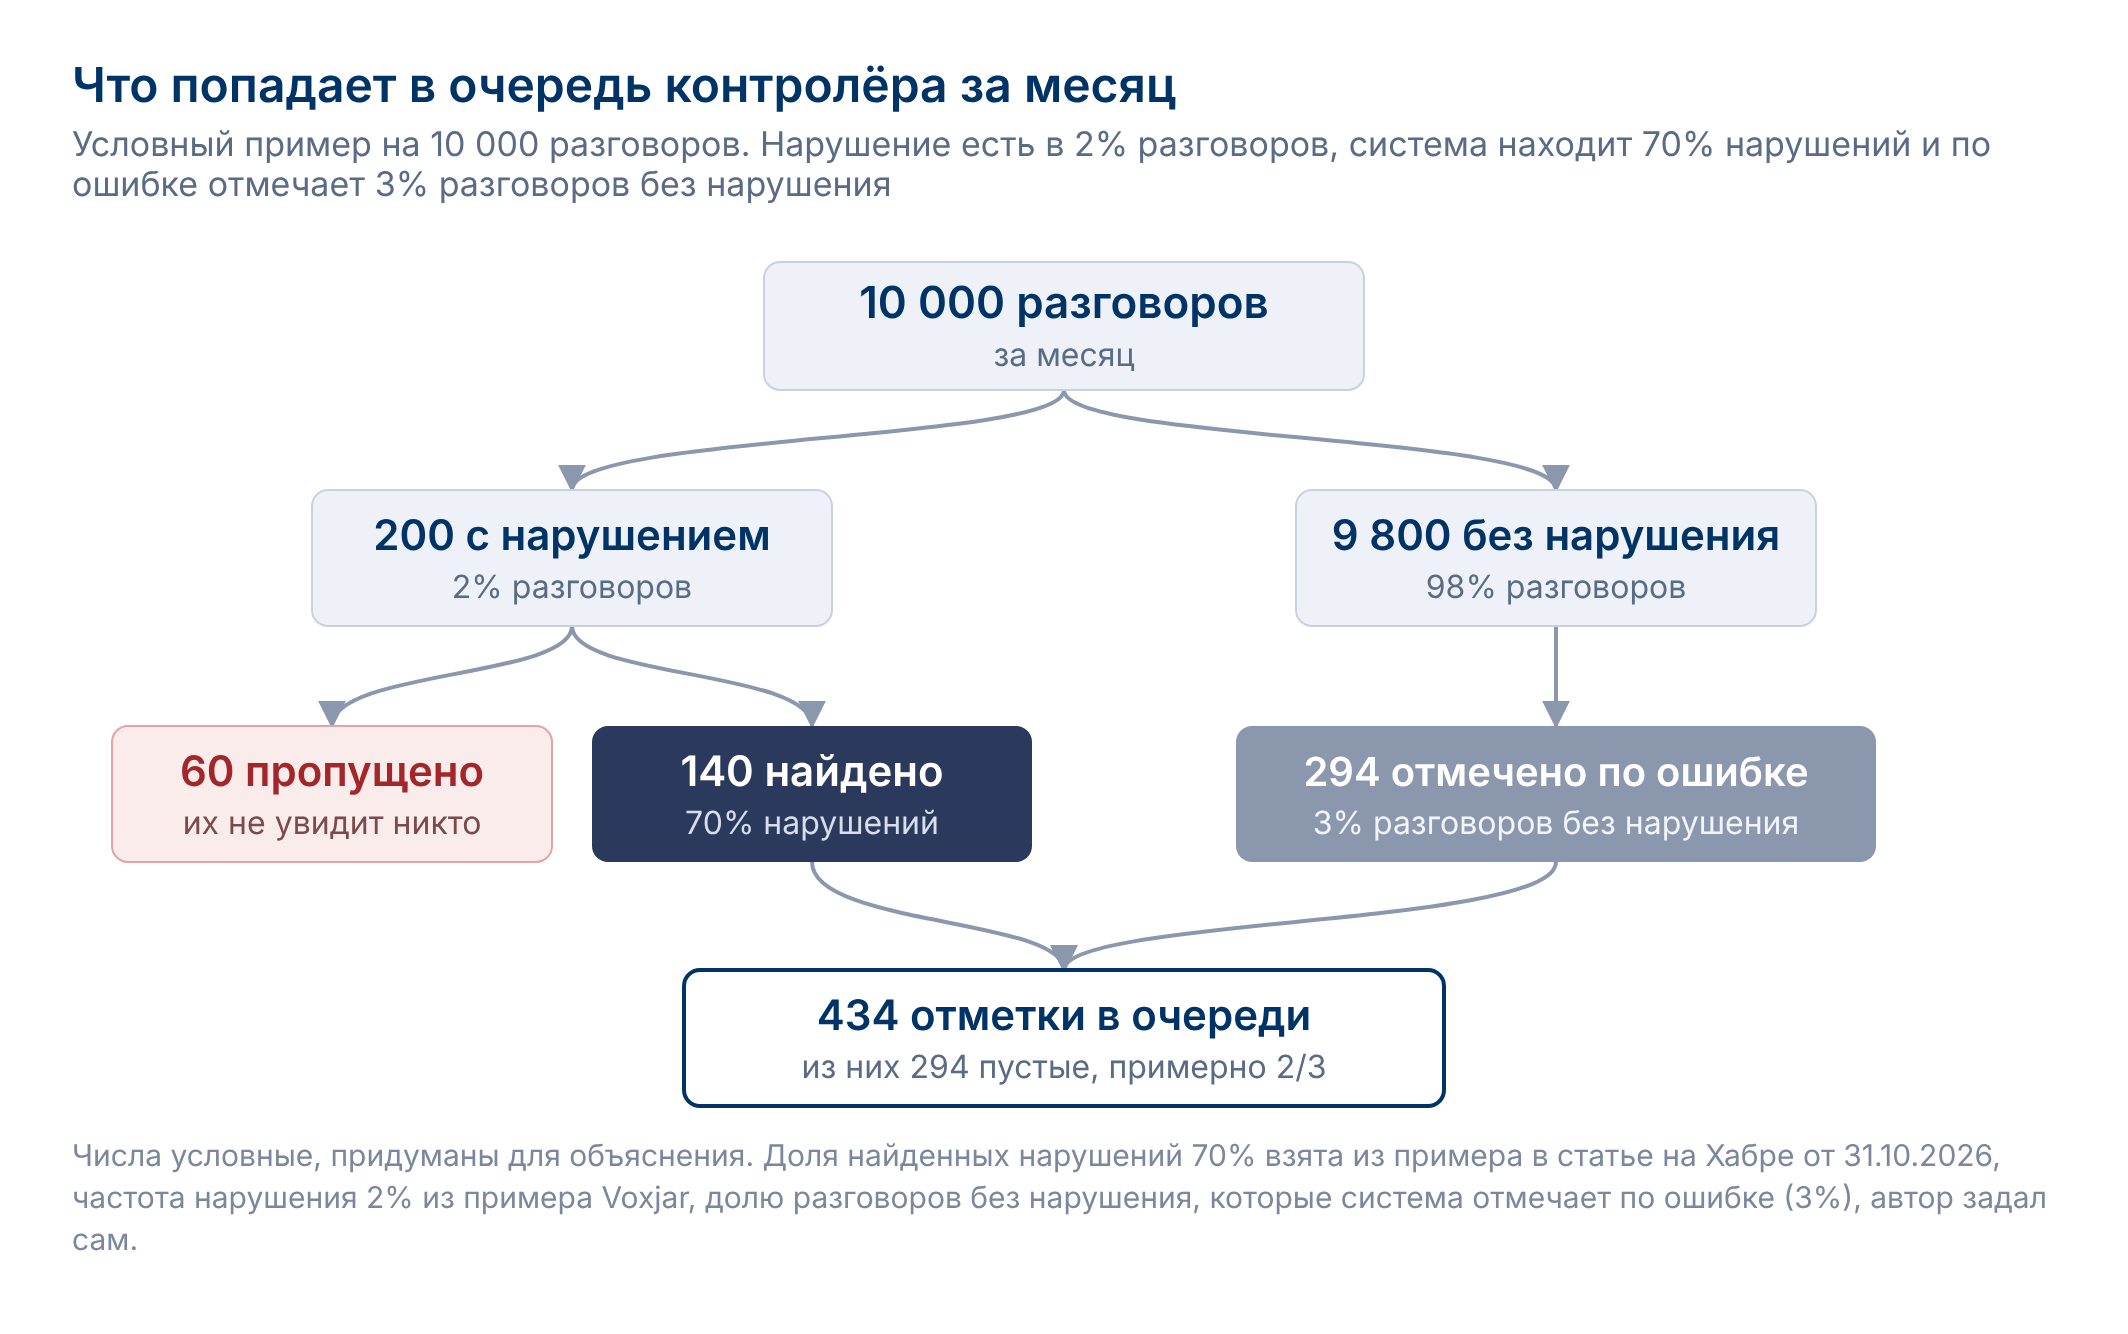
Человек проверяет только отмеченное, поэтому 60 пропущенных нарушений не увидит никто. В таблице то же для более редкого и более частого нарушения и для разных долей ложных тревог.
| Как часто встречается нарушение | Нарушений за месяц | Система нашла | Система пропустила | Пустых отметок при ложных тревогах в 3% разговоров без нарушения | Доля пустых отметок в очереди при ложных тревогах в 1%, 3% и 5% разговоров без нарушения |
|---|---|---|---|---|---|
| в 1 разговоре из 200 (0,5%) | 50 | 35 | 15 | около 300 | 74%, 90% и 93% |
| в 1 разговоре из 50 (2%) | 200 | 140 | 60 | 294 | 41%, 68% и 78% |
| в 1 разговоре из 20 (5%) | 500 | 350 | 150 | 285 | 21%, 45% и 58% |
*Условный пример на 10 000 разговоров в месяц при полноте 70%, данных подрядчиков в таблице нет.*
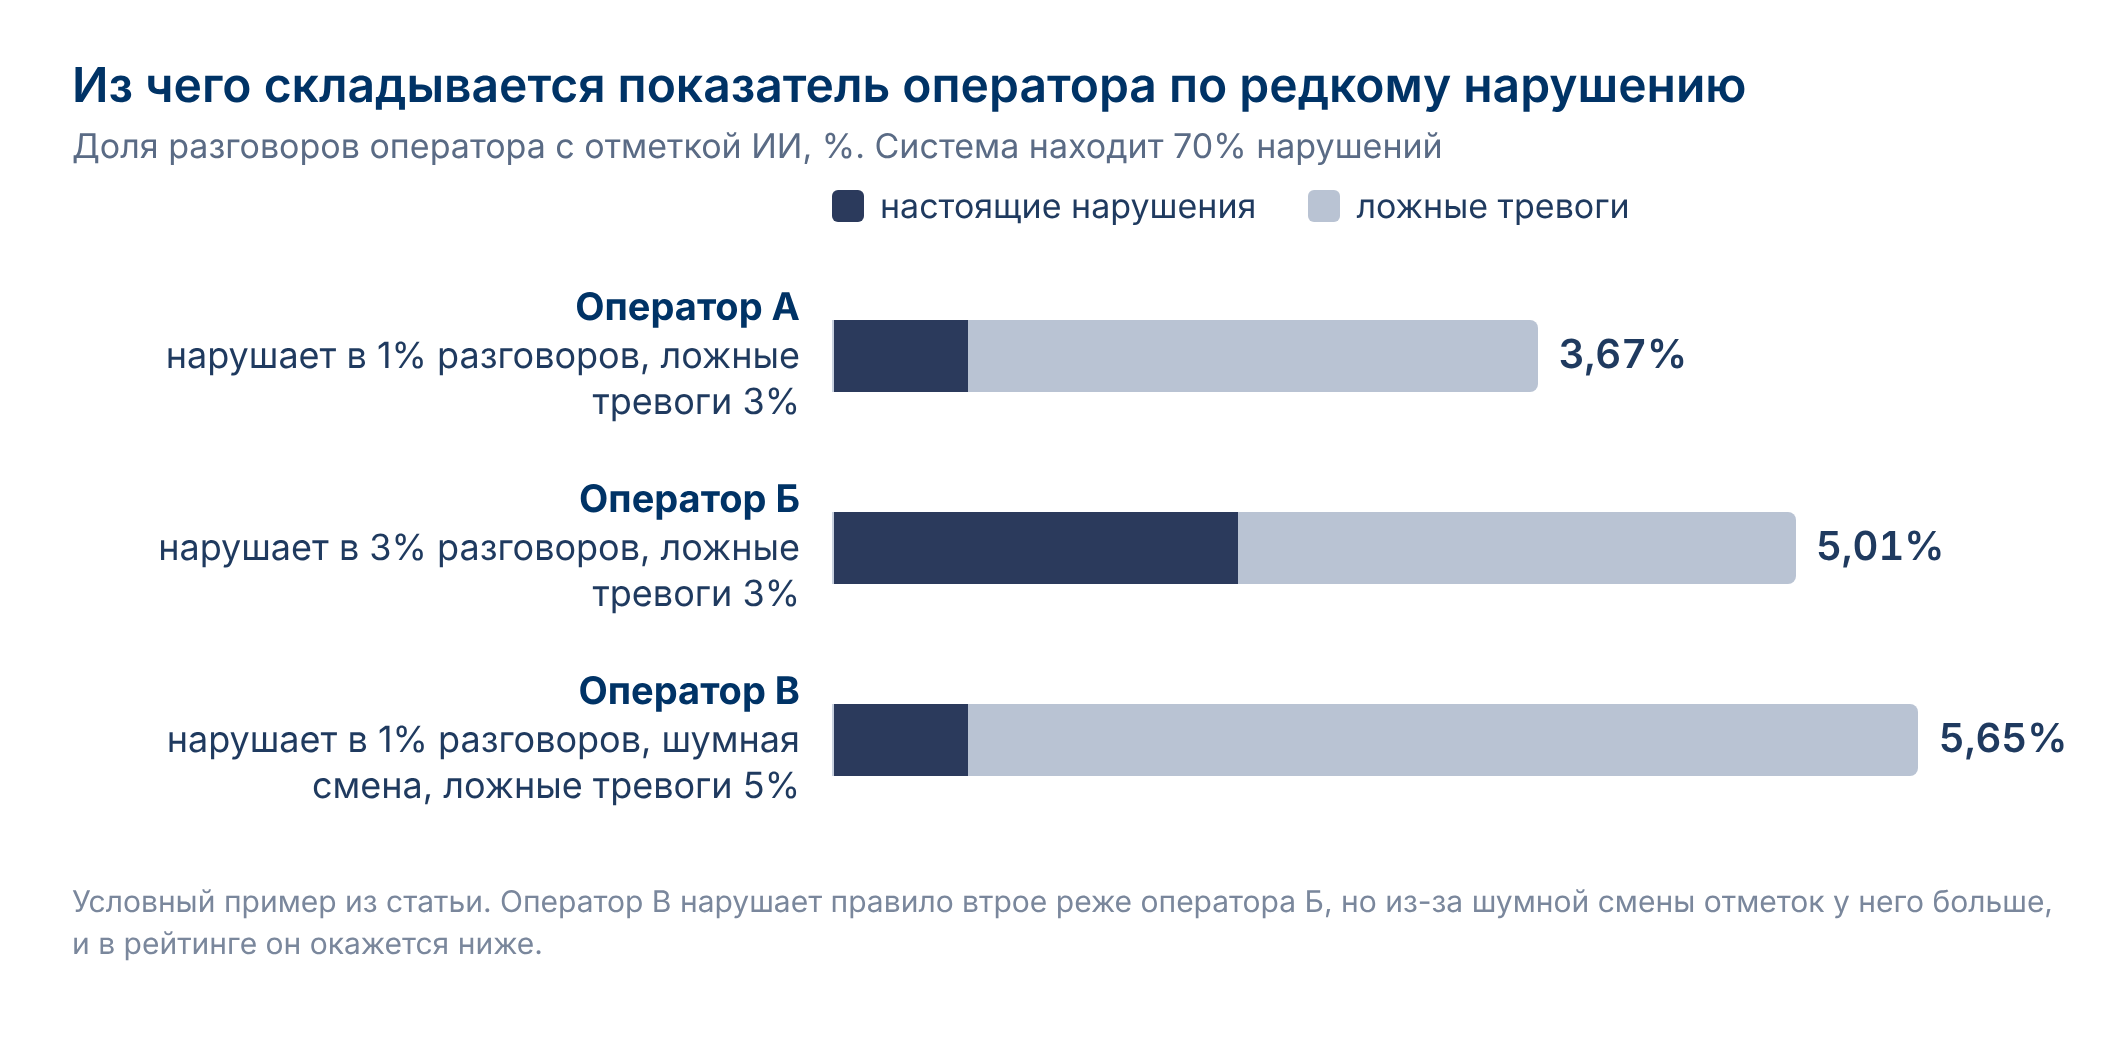
Те же ложные тревоги попадают и в показатель оператора. При той же полноте 70% и доле ложных тревог 3% оператор, который нарушает правило в 1% разговоров, получит отметки в 3,7% его разговоров (1% × 70% + 99% × 3% ≈ 3,67%), и около 4/5 из них будут ложными. Оператор с 3% нарушений получит отметки в 5,0% разговоров. Если доля ложных тревог у обоих одинаковая, разница между ними состоит из настоящих нарушений, но она сжата. Втрое более частое нарушение даёт лишь примерно в 1,4 раза больше отметок. Хуже, если доля ложных тревог у операторов разная. Оператору с 1% нарушений достаточно 5% ложных тревог вместо 3% (например, в шумной смене), чтобы получить 5,65% отметок (1% × 70% + 99% × 5% ≈ 5,65%) и оказаться в рейтинге ниже оператора с 3% нарушений. Поэтому долю ложных тревог мерят отдельно по сменам и группам операторов, общей доли для сравнения людей мало.
Вторая, самостоятельная причина ошибиться в выводе об операторе описана в той же статье на Хабре в разделе «Ошибки агрегации». Если один оператор отвечает на простые вопросы, а другой принимает претензии, сравнение только по средней оценке ведёт «к неправильному управленческому выводу» даже при верной оценке каждого разговора.
Как ошибки распознавания речи меняют оценку работы оператора
До оценки разговор нужно перевести в текст, и уже здесь появляются ошибки. Их обычно меряют долей ошибочных слов (WER), то есть долей слов, которые программа распознавания записала неверно, пропустила или добавила по сравнению с эталоном. Эталоном называют расшифровку, которую считают правильной. Вторая версия (вариант RNNT) открытой модели распознавания русской речи GigaAM на звонках колл-центра ошибается в 12,9% слов по замеру её авторов (страница результатов на GitHub, ноябрь 2026 года) и в 10,22% по замеру, который приводят в описании модели распознавания речи T-one (2025 год) её создатели. Наборы или условия замера у двух команд разные, и из таких чисел не следует, сколько ошибок будет на записях конкретного контакт-центра.
От выбора эталона зависит и то, какая программа окажется лучше. В том же описании T-one приведены результаты на открытом наборе телефонных разговоров OpenSTT в двух версиях разметки. На исходной у T-one 20,27% ошибочных слов, у второй версии GigaAM 20,07%. На переразмеченной у T-one 7,94%, у GigaAM 11,14%, и первое место переходит к другой программе. Кто и как переразмечал набор, в описании не сказано. Поэтому эталон для проверки, на мой взгляд, лучше готовить самому заказчику.
Средняя доля ошибочных слов к тому же прячет ошибки в словах, от которых зависит оценка. Автор статьи на Хабре о правильном распознавании и неправильной оценке приводит пример с потерянной частицей «не» («Мы можем подключить интеграцию» и «Мы не можем подключить интеграцию»). В Ленремонте реплики собеседников иногда «слипались», а у некоторых звонков «все фразы попадали под одного спикера», то есть программа не отличала оператора от клиента.
Поэтому на части записей стоит сделать ручную расшифровку, посчитать долю ошибочных слов и отдельно проверить отрицания, суммы, сроки, названия услуг и то, правильно ли разделены оператор и клиент. Затем оценку на тех же разговорах прогоняют дважды, по машинной расшифровке и по ручной, и сравнивают результаты по каждому критерию. Разница покажет, какую часть ошибок оценки даёт распознавание.
Как провести пилот речевой аналитики на записях звонков контакт-центра до договора на внедрение
Подготовку (шаги 1-3 ниже) компания может начать до встречи с подрядчиками или вести параллельно. На первой встрече я рекомендую задать три вопроса:
- На каком наборе разговоров, против чьих оценок и по каким критериям получен названный процент точности?
- Согласен ли подрядчик на прогон на данных контакт-центра (его система оценивает записи компании, а её отметки сравнивают с проверенными оценками контролёров) и даст ли отчёт по каждому критерию, где видно, сколько нарушений найдено, сколько пропущено, сколько пустых отметок придёт контролёрам за месяц и сколько ошибочных слов даёт распознавание на записях компании?
- Кто подтверждает оценку перед премией или взысканием, по чему (по фрагменту записи, который открывается из отметки, или по пересказу ИИ) и как оператор может оценку оспорить?
Отсеять стоит тех, кто не может описать замер, отказывается от прогона или не показывает фрагмент записи у отметки (зачем он нужен, сказано в шаге 6). Прогон по всем критериям требует настраивать их под систему каждого подрядчика и поэтому занимает время. В Лемана ПРО, например, пилот удлинили, «чтобы все откалибровать на реальных звонках». Поэтому работу я бы вёл в два этапа. Сначала короткая проверка двух-трёх оставшихся подрядчиков на двух-трёх критических критериях по записям прошлых месяцев, затем пилот по всем критериям у одного-двух финалистов на тех же записях.
Порядок работы такой:
- Записать критерии словами компании. Автор статьи о правильном распознавании и неправильной оценке советует начинать с «операционного определения: что именно считается успешным выполнением и какие исключения допустимы». В Ленремонте исходный список критериев, проверенный на 10 разговорах каждого типа, оказался «скорее теоретическим». В Лемана ПРО отказались от единых правил для всех и перешли на чек-листы по тематикам обращений, которых у компании «50 с лишним».
- Перепроверить оценки контролёров компании. Начать можно с оценок прошлых месяцев, но их точность тоже неизвестна. Одни и те же разговоры стоит дать двум контролёрам, посмотреть, как часто их оценки совпадают по каждому критерию, и согласовать спорные случаи. Требовать от ИИ совпадения с контролёром выше, чем совпадают между собой два контролёра, вряд ли имеет смысл. Публичных российских данных о том, как часто ИИ совпадает с контролёрами и как часто контролёры совпадают между собой, найти не удалось.
- Собрать проверочный набор из двух частей. Чтобы измерить долю ложных тревог около 3% с погрешностью ±1 процентный пункт в 95 случаях из 100, нужно около 1 100 разговоров без нарушения. Если эту долю сравнивают по сменам или группам операторов, такой объём нужен на каждую смену или группу. При делении тех же 1 100 разговоров на четыре смены погрешность вырастает до ±2 процентных пунктов, и 3% от 5% уже не отличить. Настоящих нарушений случайный отбор даёт мало. При частоте 2% на 50 нарушений в среднем нужно разметить 2 500 разговоров, но тогда 50 наберутся лишь в половине случаев, а 3 000 разговоров дают их с вероятностью около 92%. Поэтому в набор добавляют известные нарушения из жалоб и прошлых проверок. Такие нарушения могут быть заметнее средних, и полнота на них может оказаться выше, чем на всех разговорах. При 50 нарушениях и найденных 70% погрешность полноты около ±13 процентных пунктов, при 100 около ±9. Долю пустых отметок на таком наборе считать нельзя. При той же полноте 70% и доле ложных тревог 3% на 50 нарушениях и 1 100 разговорах без нарушения подтвердится около половины отметок, а среди всех разговоров месяца при частоте 2% только 32%. Поэтому долю пустых отметок в будущей месячной очереди пересчитывают по полноте, доле ложных тревог и числу разговоров с нарушением и без него за месяц. Частоту нарушения для этого берут из случайной части набора или из оценок контролёров прошлых месяцев (шаг 2).
Доля пустых отметок за месяц = доля ложных тревог × разговоры без нарушения / (полнота × разговоры с нарушением + доля ложных тревог × разговоры без нарушения)
Для условного примера это 3% × 9 800 / (70% × 200 + 3% × 9 800) = 294 / 434, примерно 2/3.
- Прогнать системы подрядчиков на одном и том же наборе. На короткой проверке это два-три критических критерия у каждого из оставшихся подрядчиков, на пилоте все критерии у финалистов. На части записей оценку прогоняют отдельно по машинной и по ручной расшифровке.
- Получить отчёт по каждому критерию с числами из второго вопроса, на короткой проверке по критическим критериям, на пилоте по всем. Долю ложных тревог в нём стоит посчитать отдельно по сменам и группам операторов, иначе нельзя понять, можно ли сравнивать операторов между собой.
- Проверить, открывается ли у каждой отметки фрагмент разговора. Voxjar прямо пишет, что оценка, которую нельзя привязать к цитате из расшифровки, доказательством не является, кто бы её ни поставил. У ОТП Банка, по материалу Naumen, разбор диалога экспертом сократился с 7 минут до 20 секунд «благодаря саммаризации диалога», то есть эксперт знакомится с диалогом по пересказу ИИ. Поэтому из пересказа должен сразу открываться нужный фрагмент записи.
Отдельно решают, на чьих серверах идёт прогон. Записи звонков содержат персональные данные клиентов и операторов. Передать их подрядчику значит поручить ему обработку персональных данных, а такое поручение 152-ФЗ допускает «с согласия субъекта персональных данных, если иное не предусмотрено федеральным законом, на основании заключаемого с этим лицом договора» (ч. 3 ст. 6). Субъект персональных данных в законе означает человека, чьи это данные. Если прогон идёт на серверах подрядчика, договор, на основании которого ему поручают обработку записей, заключают уже на время короткой проверки и пилота, раньше договора на внедрение. Проще всего делать прогон на серверах самого контакт-центра, а как оформить передачу записей, решает юрист. О размещении LLM на серверах компании мы писали в статье о 152-ФЗ.
На чём должно основываться решение о премии или взыскании оператора по оценке ИИ
По п. 1 ст. 86 ТК РФ обработка персональных данных работника «может осуществляться исключительно в целях», перечисленных в законе, и контроль количества и качества выполняемой работы среди них назван. Значит, сама цель такой проверки входит в перечень, и главный вопрос в том, на чём основано решение по её итогам. В п. 6 той же статьи сказано, что «при принятии решений, затрагивающих интересы работника, работодатель не имеет права основываться на персональных данных работника, полученных исключительно в результате их автоматизированной обработки или электронного получения». Норма говорит о том, на чём основано решение. Подпись руководителя под баллом ИИ, по моей оценке, не меняет того, что решение основано на автоматической оценке, поэтому решение о премии, взыскании или отстранении от линии должно опираться на запись разговора, которую проверил человек. Как понимать в этой норме слова «электронного получения» применительно к записям, которые человек проверил, по тексту не ясно, это вопрос к юристу.
Для дисциплинарного взыскания порядок задан ст. 193 ТК РФ. До взыскания работодатель должен затребовать у работника письменное объяснение, а само взыскание работник может обжаловать в государственную инспекцию труда и (или) органы по рассмотрению индивидуальных трудовых споров. Для премии и допуска к линии порядок оспаривания, по моей оценке, задают локальные акты компании.
Ст. 16 152-ФЗ запрещает принимать «на основании исключительно автоматизированной обработки персональных данных» решения, которые порождают юридические последствия для человека, чьи это данные, или иным образом затрагивают его права и законные интересы. Такое решение допустимо только при письменном согласии этого человека или в случаях, предусмотренных федеральными законами (ч. 2 той же статьи). Норма касается любой компании, которая обрабатывает персональные данные, включая ритейл и доставку. Для оператора контакт-центра как работника письменное согласие, по моей оценке, запрета п. 6 ст. 86 ТК РФ не снимает, подобного исключения в Трудовом кодексе нет.
Какие показатели смотреть после запуска ИИ-контроля качества звонков
После запуска стоит следить за тремя рядами показателей. Первый ряд - это качество самих отметок, то есть полнота, доля пустых отметок и доля ложных тревог по каждому критерию. «Капитал LIFE» периодически проверяет качество работы ИИ на выборке диалогов. Для такой проверки нужна свежая выборка разговоров с оценками контролёров, а набор, на котором выбирали подрядчика, покажет, не ухудшилась ли система после обновления. Второй ряд - это соблюдение чек-листа операторами, которое система меряет теми же отметками. В Лемана ПРО соблюдение скриптов выросло с 41 до 94%. Без первого ряда неизвестно, какая часть такого роста приходится на ошибки отметок, а если до внедрения скрипты мерили выборкой, а после системой, часть роста может объясняться сменой способа замера. Третий ряд - это результат для клиента. ОТП Банк, по тому же материалу Naumen, на 1,7 процентного пункта увеличил долю вопросов, решённых с первого обращения, а в Лемана ПРО показатель Resolved Issue Rate, то есть доля вопросов, решённых по мнению клиента, вырос с 58 до 77%. Смотреть стоит все три ряда, ни один из них другие не заменяет.
С чего начать внедрение ИИ-контроля качества в контакт-центре
Система ИИ-контроля качества звонков в опубликованных кейсах складывается из распознавания речи, оценки по критериям (у ОТП Банка массовые проверки делает машинное обучение, а LLM подключается, где нужен контекст разговора), очереди отметок для контролёров и оповещений. Начинать я рекомендую с шагов 1-3 из раздела о пилоте, потому что критерии, перепроверенные оценки контролёров и проверочный набор останутся у компании при любом выборе подрядчика.
Пилот речевой аналитики полезен тогда, когда по его итогам известно, сколько нарушений система находит, сколько пропускает и сколько отмечает по ошибке. Проверку на данных компании до покупки мы описывали и для ИИ-агентов в 1С и CRM.
Мы в БизнесМатике делаем Владу, ИИ-специалиста клиентского сервиса. Среди прочего Влада оценивает разговоры операторов по критериям компании и к каждой оценке прикладывает цитату из разговора. Работу с ней компания может начать с архива прошлых разговоров. Подходить к Владе я рекомендую с теми же тремя вопросами из раздела о пилоте, что и к любому подрядчику речевой аналитики.
