В начале октября 2026 года Яндекс через своё подразделение технологий для бизнеса Yandex B2B Tech объявил о гибридном поиске в базе данных YDB. Такой поиск одновременно ищет по точному совпадению символов и по смыслу слов. Поиск по смыслу обычно устроен как векторный, то есть запрос и описание товара переводятся в наборы чисел, и система ищет близкие наборы. Технический директор YDB Андрей Фомичев объясняет в пресс-релизе, зачем объединять поиск по словам и поиск по смыслу. «Если использовать только векторный поиск, система может пропустить точные термины, номера документов или специфические коды», - говорит он. В статье команды YDB на Хабре приведён условный пример, где покупатель интернет-магазина пишет в одной строке артикул и «что-нибудь тёплое на осень в офис».
Для интернет-магазина или B2B-дистрибьютора с большим каталогом из этого следует, что поиск по смыслу может пропустить именно то, по чему покупатель ищет конкретный товар, то есть артикул или номер модели. Многие сервисы поиска для интернет-магазинов продают сочетание поиска по словам и поиска по смыслу под названием «умный поиск». Сочетание этот риск уменьшает, но не убирает. «Гибрид улучшает попадание, но не гарантирует его», - пишет интегратор Cortex IT в статье на Хабре, разобранной ниже. Если артикул записан в каталоге иначе, чем его набрал покупатель, поиск по словам может этот товар не найти. Поиск по смыслу может считать почти одинаковыми изделия одной серии с близкими номерами. В случае Cortex IT, где искали по документации, из-за этого находился паспорт соседней модели станка. На витрине магазина, по моей оценке, так выше нужного товара может встать карточка соседнего.
В обоих случаях пустой страницы покупатель, как правило, не увидит. Retail Rocket Group, компания, которая продаёт магазинам поиск и рекомендации товаров, на странице своего сервиса поиска пишет, что система «всегда находит релевантный результат вместо пустой страницы поиска». В опубликованных кейсах сервисов поиска пользу внедрения часто подтверждают снижением доли запросов без результатов (примеры ниже), и ошибку с соседней моделью эта цифра не покажет. Я считаю, что если умный поиск по умолчанию показывает похожие товары, доля запросов без результатов окажется низкой почти у любого поставщика и перестанет помогать в выборе между ними. На пилоте, до договора с поставщиком поиска, стоит проверить на реальных запросах покупателей из истории поиска магазина две вещи. Первая из них - это доля запросов о товарах из каталога, по которым нужного товара нет среди первых пяти результатов, а вместо него показаны другие. Вторая - это то, сколько из первых пяти результатов подходят широким запросам и запросам-задачам вроде «что-нибудь тёплое на осень в офис».
Какая доля выручки интернет-магазина приходится на покупателей, которые пользуются поиском
Доли выручки и заказов, опубликованные для разных магазинов, сильно отличаются.
| Магазин | Что посчитано | Доля | Источник |
|---|---|---|---|
| Интернет-магазин Lamoda | выручка с поиска | около 25% | статья команды поиска Lamoda на Хабре, декабрь 2025 года |
| Магазин бытовой техники, пример из блога Retail Rocket Group | выручка от посетителей, которые пользуются поиском (около 20% всех посетителей) | около 60% | публикация Retail Rocket Group, 2024 год |
| Мебельный интернет-магазин, клиент сервиса поиска anyQuery, который разрабатывает компания any | выручка посетителей с поиском с 20 мая по 18 июня 2026 года, 9,39 млн руб. из 239,8 млн руб. | 3,9% | кейс anyQuery, июнь 2026 года |
| Отраслевой маркетплейс стоматологических товаров, клиент сервиса поиска SearchBooster | заказы через поиск в октябре 2025 года | 74% | партнёрский материал SearchBooster в издании об электронной торговле Oborot.ru, декабрь 2025 года |
Все четыре доли опубликовали сами магазины или сервисы поиска, независимых замеров среди них нет. В трёх случаях это доля выручки, в одном доля заказов. По этим примерам видно, что разброс долей большой, поэтому ту же долю стоит посчитать по собственной аналитике магазина. От неё зависит, сколько денег проходит через поиск и сколько стоит его ошибка.
В тех же материалах встречается сравнение посетителей, которые пользуются поиском, с остальными. В мебельном кейсе написано, что использование поиска «увеличило вероятность покупки на 46%». Посчитано это сравнением конверсии в заказ, которая у посетителей с поиском составила 3,34%, у остальных 2,28%. На мой взгляд, такое сравнение эффекта поиска не показывает. Человек, который набрал запрос, обычно уже знает, что хочет купить, и чаще покупает при любом поиске. Насколько вырастут продажи из-за нового поиска, показывает только A/B-тест с контрольной группой посетителей, о нём ниже.
Почему доля запросов без результатов перестаёт различать поставщиков умного поиска, когда поиск показывает похожие товары
Запросы, по которым поиск не нашёл ни одного товара, для магазина полезны. Retail Rocket Group называет их «болевыми точками» ассортимента и пишет, что пустая поисковая выдача - это «сигнал о потенциально упущенном спросе». Lamoda, по статье её команды, ежедневно собирает по каждому поисковому запросу набор метрик, среди которых количество пустых выдач и количество коротких выдач, где найдено меньше 60 товаров.
В публикации 2025 года Retail Rocket Group по внутренним данным пишет, что в среднем около 15% запросов приводят на пустые страницы. О каком поиске речь, компания не уточняет. В кейсах сервиса anyQuery долю запросов без результатов снижали разными способами.
| Магазин | Кейс опубликован | Доля запросов без результатов | Как снижали |
|---|---|---|---|
| Магазин стройматериалов | 2023 год | с 32% до 1,88% | внедрили поиск с исправлением опечаток, неверной раскладки клавиатуры и транслита и с подсказками при наборе |
| Магазин шин и дисков Koleso | 2023 год | с 62% до 2% | расширили данные о товарах в каталоге, разобрали более 20 тысяч запросов без результатов и для многих добавили синонимы |
| Domingo, магазин стройматериалов | 2024 год | на 83% меньше | показ похожих товаров вместо пустой страницы |
| Первомастер, магазин стройматериалов | 2024 год | на 81% меньше | так же, кейс общий с Domingo |
Domingo и Первомастер снижали долю запросов без результатов третьим способом. «Такой результат достигается благодаря настройке страниц аналоговой выдачи, когда пользователю предлагаются аналогичные товары при отсутствии запрашиваемых», - объясняют в их общем кейсе.
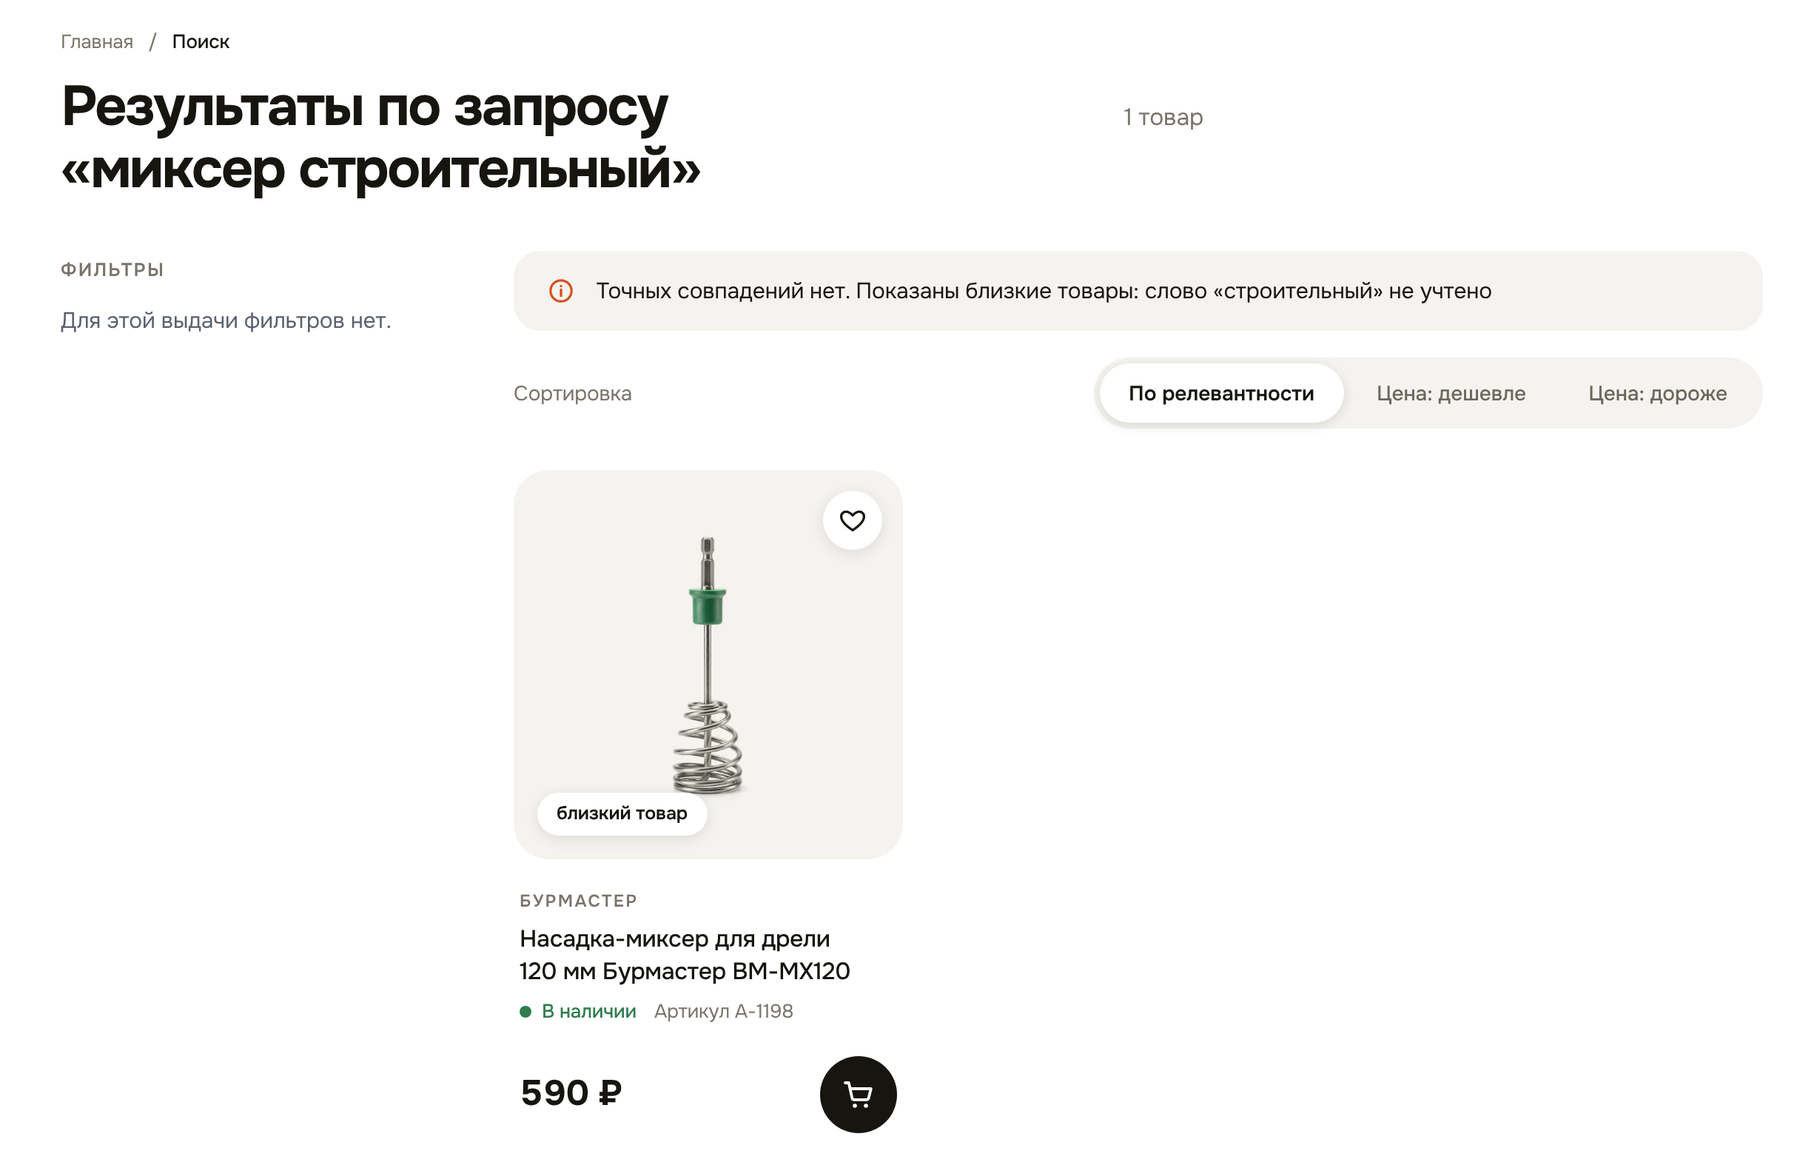
Если поиск по умолчанию подставляет похожие товары, итоговая доля запросов без результатов будет низкой у любого поставщика. По ней уже не видно, сколько покупателей вместо нужного товара получили только замену. Поэтому у поставщика стоит просить другую цифру, долю запросов, по которым поиск не нашёл точного совпадения и показал похожие товары, вместе со списком таких запросов. На пилоте магазин может посчитать долю замен и по собственной разметке запросов. Как это сделать, сказано в разделе о доле замен ниже.
Кейс Технопарка, федеральной сети магазинов бытовой техники и электроники (март 2026 года), показывает случай, когда результаты поиска были, но вверху стояли не те товары. Технопарк уже пользовался умным поиском anyQuery, но по популярным запросам вверху результатов оказывались, как сказано в кейсе, «аксессуары, смежные категории или товары с косвенными синонимами». По запросу «дегидратор» вверху стояли сушильные машины, по запросу «лампа» лампочки. После дообучения поиска под намерение покупателя метрика nDCG, которая оценивает порядок результатов, выросла на 5,8%, конверсия в заказ на 9%. Как замеряли, в кейсе не сказано.
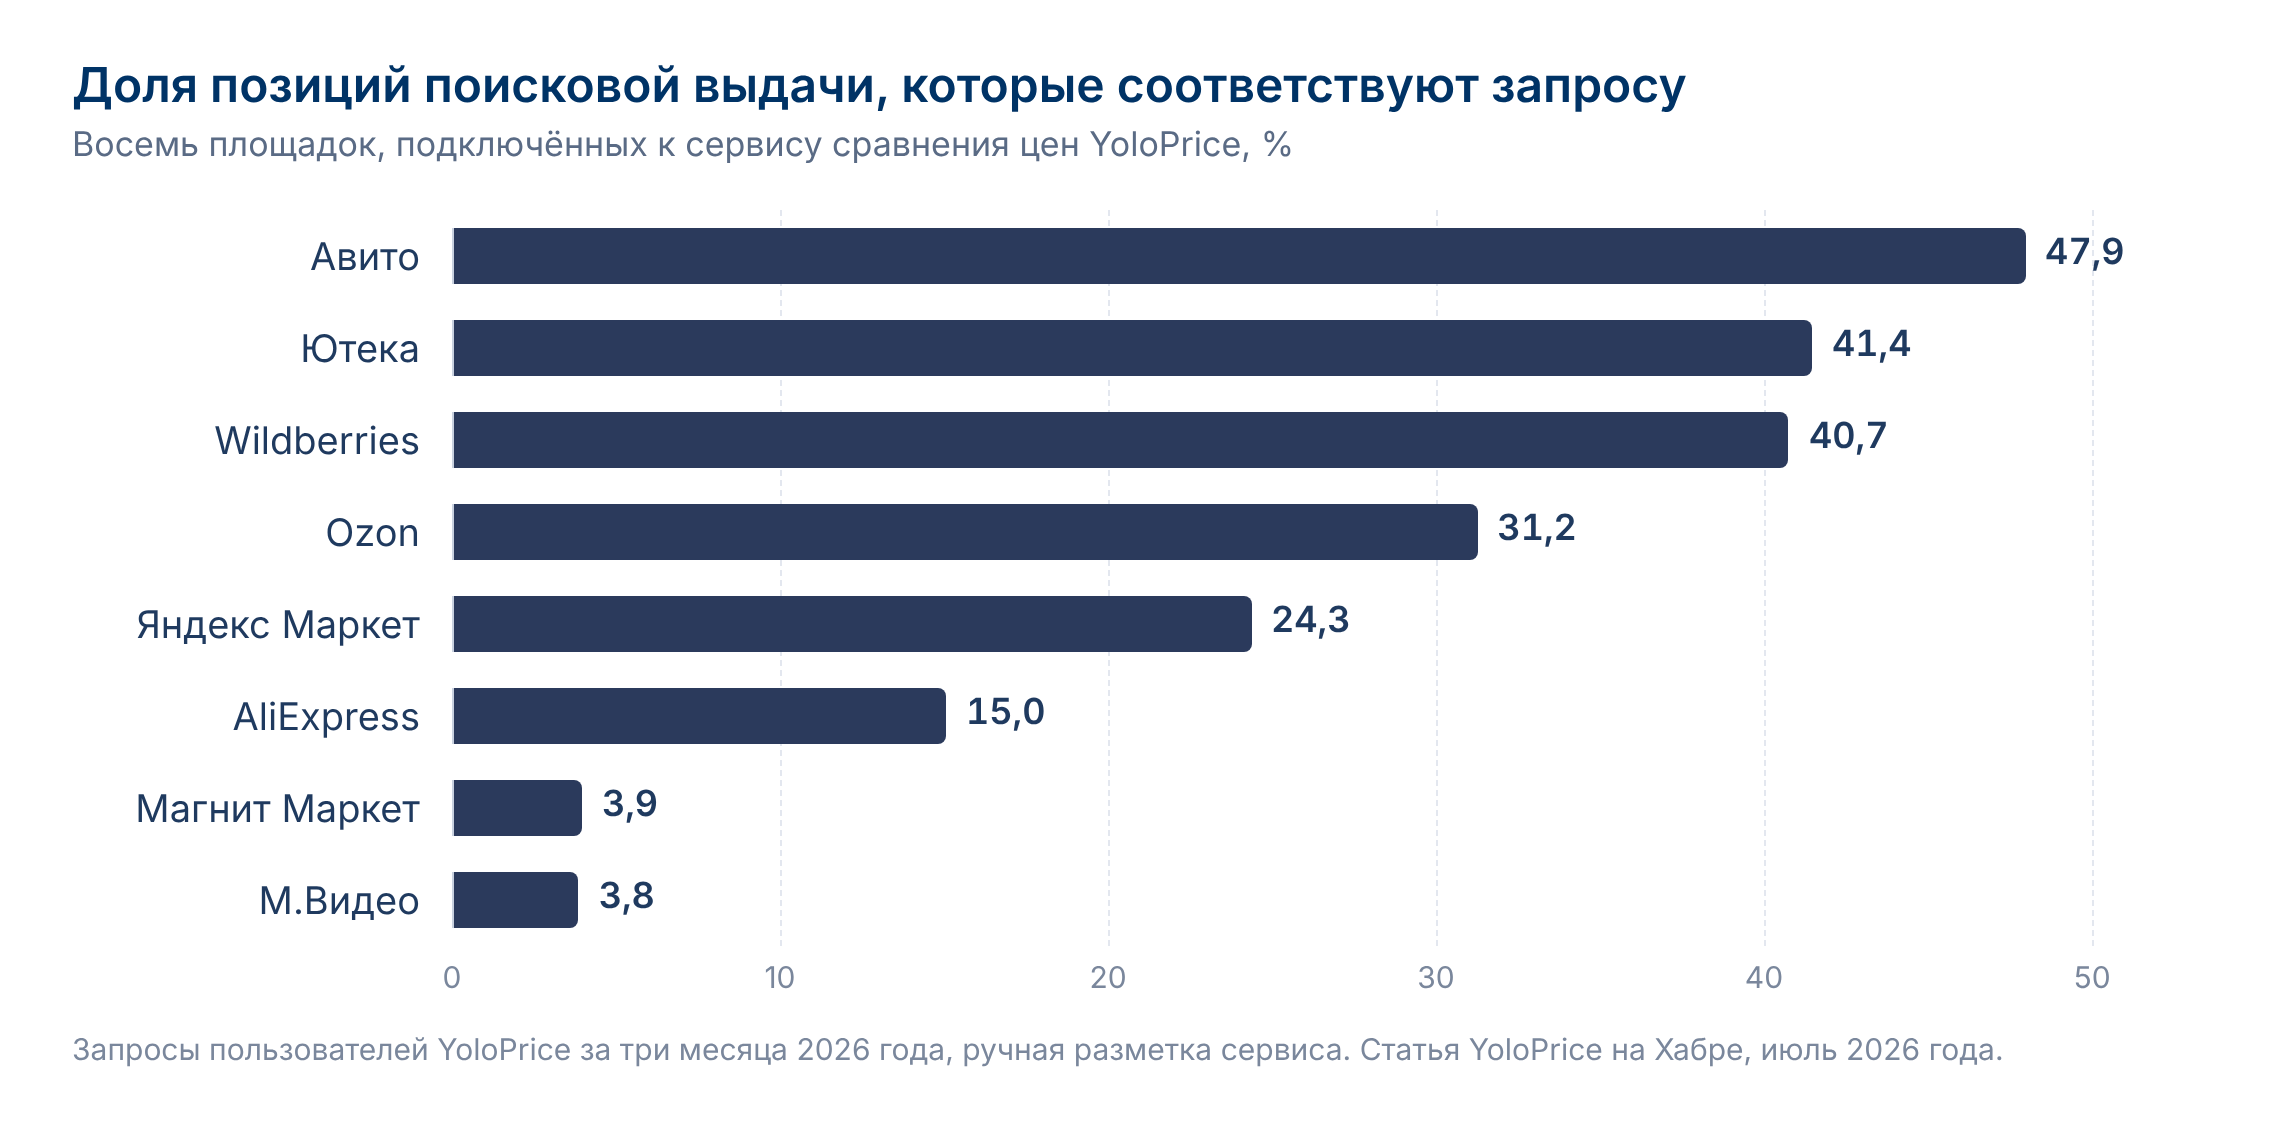
Как выглядят результаты поиска на крупных площадках, показывает замер сервиса сравнения цен YoloPrice (статья июля 2026 года). Сервис взял запросы своих пользователей за три месяца 2026 года и посчитал, какая доля позиций в поисковой выдаче восьми площадок соответствует запросу. У Wildberries таких позиций 40,7%, у Ozon 31,2%, у Яндекс Маркета 24,3%. Авторы оговаривают, что у крупных маркетплейсов поисковая выдача «сознательно разбавляется похожими и сопутствующими товарами». У Магнит Маркета доля релевантных позиций 3,9%, у М.Видео 3,8%. Часть запросов выходит за их ассортимент, и поиск «вместо пустого результата возвращает «хоть что-нибудь»». Для покупателя, который ищет конкретный товар, «честный ответ "у нас такого нет" был бы полезнее ленты случайных позиций», считают авторы. Выше всех в замере Авито (47,9%). По словам авторов, отчасти это объясняется тем, что поисковая выдача Авито состоит из объявлений и у площадки меньше стимулов разбавлять её похожими и рекламными позициями, чем у классических маркетплейсов. Небольшие специализированные площадки вроде Ютеки (41,4%), по словам авторов, выигрывают за счёт узкой специализации. Глубину поисковой выдачи в замере они не указывают и сами предупреждают, что не измеряют объективное качество поиска.
На каких запросах поиск по каталогу ошибается
Запросы, на которых поиск ошибается, удобно разделить на шесть групп и по ним же проверять поставщика поиска:
- Опечатки, неверная раскладка и латиница. Команда поиска Lamoda описывает отдельный модуль, который должен одинаково понимать «reebok», «рибок» и «reeboc».
- Синонимы и бытовые названия, например «штаны» и «брюки», «свитер» и «джемпер» (тоже Lamoda), и смежные товары, которые поиск принимает за синонимы, как сушильные машины по запросу «дегидратор» у Технопарка.
- Артикулы и номера моделей в другом написании. В кейсе Koleso, опубликованном в 2023 году, поиск магазина до подключения anyQuery не находил артикул «-D04517» по запросу «4 517».
- Сокращения, единицы и символы, например «tv» вместо «television» или знак дюйма вместо слова «inch» в примерах Baymard Institute, исследовательской компании, которая изучает удобство интернет-магазинов.
- Запросы-задачи и отрицания, вроде «что-нибудь тёплое на осень в офис» из примера YDB или «платье не из хлопка» из исследовательского проекта на Хабре о поиске товаров с помощью LLM, о котором ниже.
- Запросы о товаре, которого нет в ассортименте.
Baymard Institute в статье, обновлённой в апреле 2026 года, пишет, что нашёл проблемы с запросами из сокращений и символов у 54% из более чем 170 изученных сайтов и приложений. С запросами по назначению товара проблемы были у 43% сайтов, с точными запросами (по названию или номеру модели) у 12%. Выборка зарубежная.
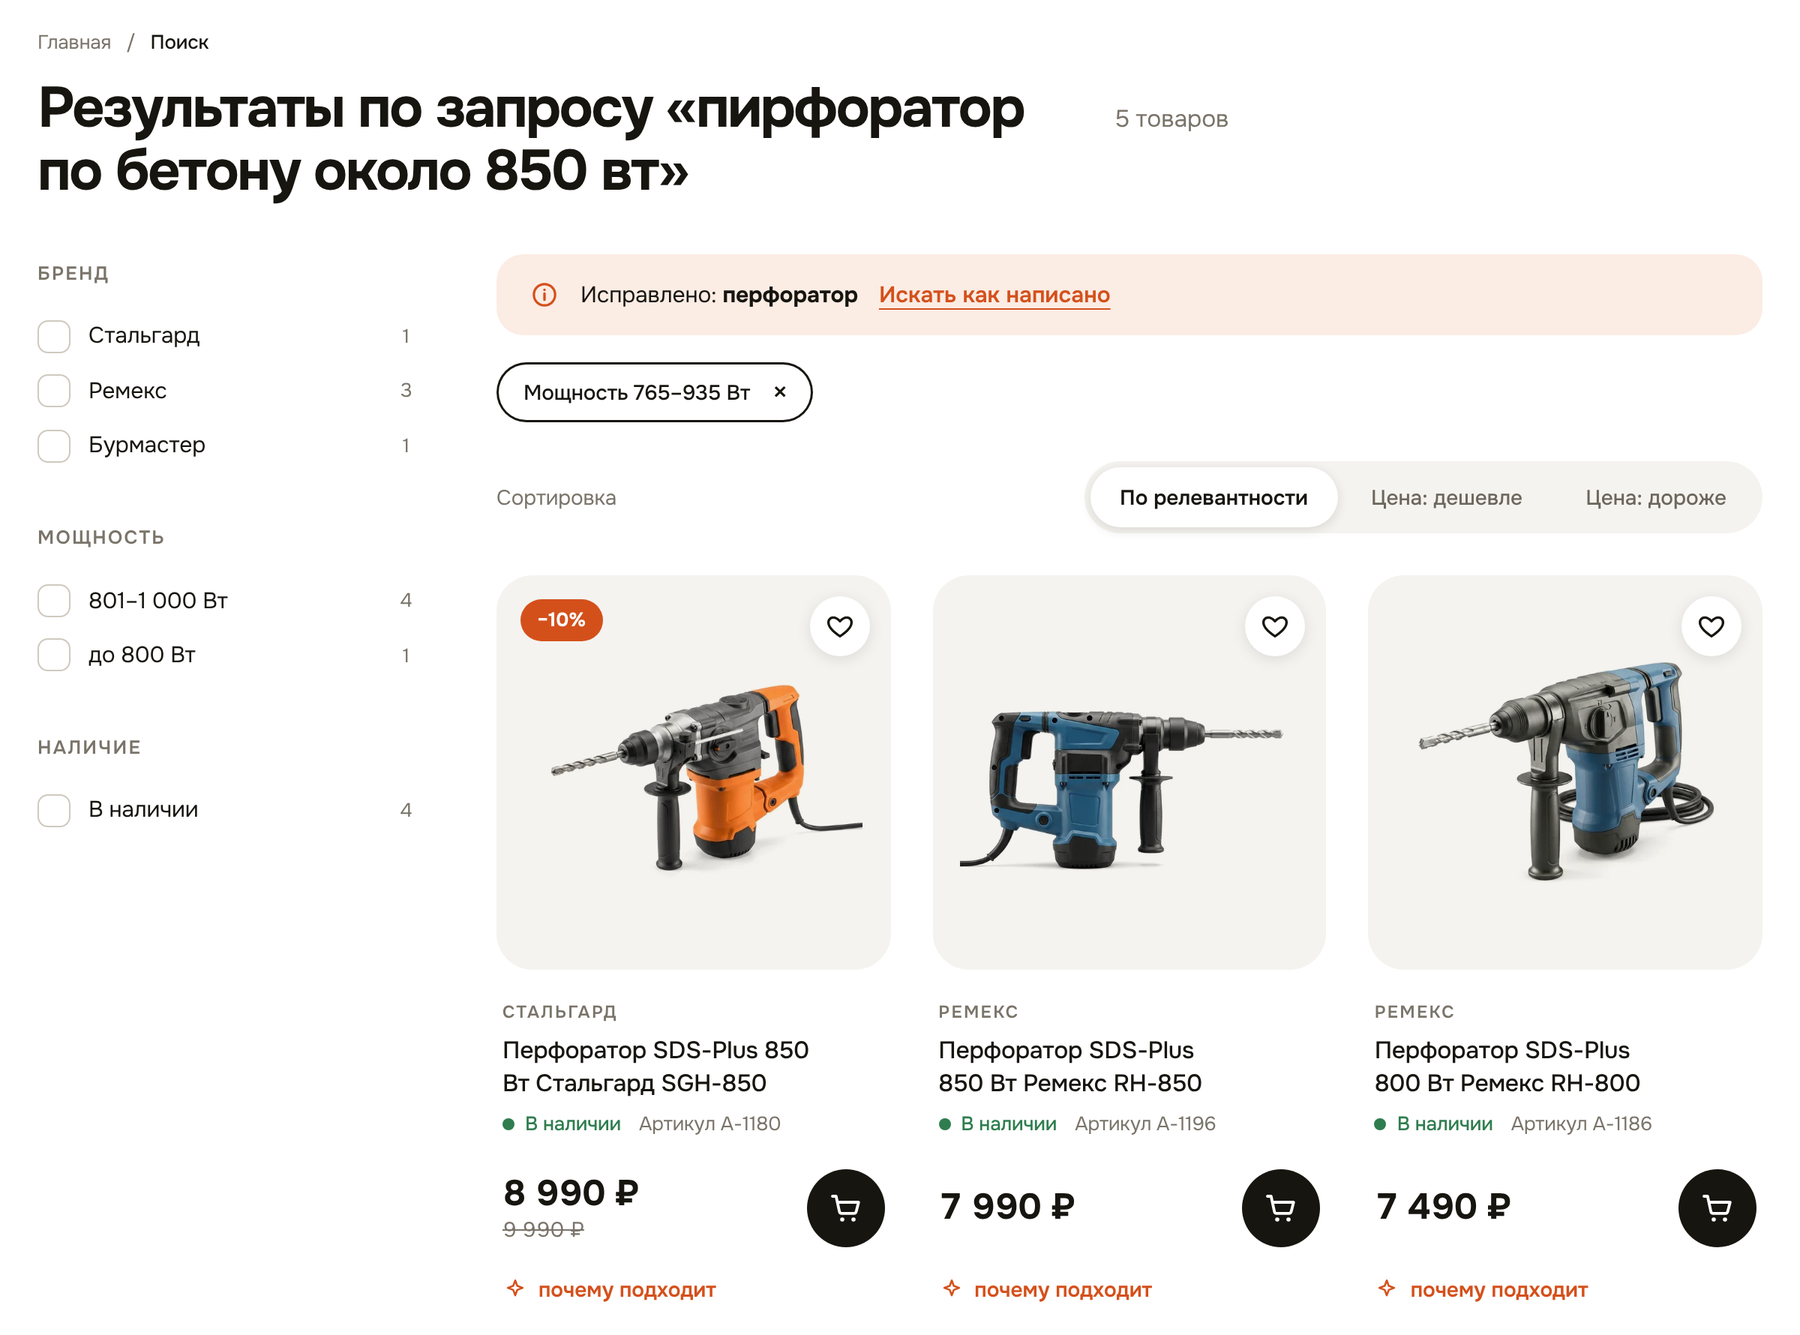
Артикулы и номера моделей требуют отдельной проверки при поиске по смыслу. Интегратор Cortex IT в статье, опубликованной в октябре 2026 года, описал систему для отдела продаж дистрибьютора промышленного оборудования. Больше сотни менеджеров ищут факты в базе из 11 тысяч файлов (паспорта станков, мануалы, спецификации, обучающие видео). В первой версии система подбирала документы только поиском по смыслу, а LLM составляла по ним ответ. По запросу о станке ФС-420М поиск приносил паспорт соседней модели, потому что в числовых описаниях смысла обозначения ФС-420М и ФС-420С почти не отличаются, и ответ LLM выглядел правильным. «Менеджер получает уверенный ответ с числом, и число это от другого станка», - пишет автор. Речь идёт о поиске по документам, но артикулы автор прямо называет среди слабых мест поиска по векторам, вместе с номерами моделей, кодами ошибок и серийными номерами. На витрине магазина, по моей оценке, так в первой строке результатов может оказаться карточка соседней модели.
Как Lamoda и Яндекс Лавка сочетают поиск по словам и поиск по смыслу
У Lamoda, по статье её команды поиска, товары-кандидаты для результатов сначала подбирает поиск по словам на ElasticSearch (система полнотекстового поиска). Нейронный поиск по смыслу подключается для запросов, по которым поиск по словам нашёл мало товаров. Затем первые 400 товаров переупорядочивает обученная ML-модель с учётом предпочтений пользователя и других факторов.
Команда сервиса доставки Яндекс Лавка в статье 2025 года показывает, почему поиск по словам остаётся нужным. Товар «Арбуз бруски „Из Лавки“, 500 г», появившийся за пару дней до проверки, нашёл только классический поиск по словам BM25. Обе нейросетевые модели поиска по смыслу, которые использует Лавка, его пропустили. Команда называет BM25 более традиционной и пишет, что она «остаётся незаменимой для поиска новых товаров и брендов, которые не охвачены нейронками из-за инертности выкаток и дообучения». В статье 2026 года та же команда пишет, что тяжёлые модели «понимали новые товары», но работали слишком медленно, и описывает кеш для частых запросов, который пересчитывается ежедневно и товары в который заранее отбирает такая модель. Для запросов вне кеша остался прежний путь, где кандидатов подбирают нейросетевая модель DSSM и поиск по словам BM25. Через сколько времени поиск по смыслу у конкретного поставщика начинает находить новый товар или бренд, стоит спросить отдельно. Этот вопрос есть в списке ниже.
Как провести пилот умного поиска для интернет-магазина на реальных запросах его покупателей до договора с поставщиком
Порядок проверки я рекомендую такой:
- Собрать набор реальных запросов покупателей из журнала поиска магазина, то есть из истории того, что люди вводили в строку поиска на сайте, и разбить его по шести группам из списка выше. Для ориентира, Lamoda каждую неделю отбирает для оценки 2200-2500 запросов и смотрит по 60 первых товаров для каждого. Среднему магазину столько не нужно, но в каждой группе я бы брал не меньше 100 запросов. При 100 запросах в группе погрешность доли правильных ответов доходит до 10 процентных пунктов в обе стороны, и разницу между поставщиками меньше этого такой набор может не показать.
- Для каждого запроса записать, что считается правильным ответом. Для запроса о конкретном товаре это сам товар, для широкого запроса или задачи это перечень подходящих товаров, для запроса вне ассортимента это допустимые замены или сообщение, что такого товара нет. Для B2B-дистрибьютора, по моей оценке, правильным ответом часто будет аналог, если поиск прямо помечает его как аналог. Правильные ответы отмечает сотрудник, который знает ассортимент, например категорийный менеджер. Lamoda часть разметки поручает LLM и проверяет её на отдельном наборе запросов. Точность такой разметки, по данным команды, 0,90, то есть неверна примерно 1 из 10 оценок, и проверка людьми остаётся нужной.
- Прогнать один и тот же набор на действующем поиске и на поиске поставщика, на каталоге магазина и без учёта истории покупателя. Поставщики обычно предлагают демонстрацию или пробный период. Компания any на страницах сервиса anyQuery предлагает собрать «бесплатное демо», а ResoSearch, сервис умного поиска для сайтов на 1С-Битрикс, даёт бесплатный период 14 дней на максимальном тарифе (по странице сервиса на 24 октября 2026 года). Для такой проверки нужно, чтобы демонстрация шла на выгрузке каталога и запросах магазина.
- Посчитать результат по группам. Для групп 1, 3 и 4 смотрят, стоит ли нужный товар первым или хотя бы среди первых пяти результатов. Для групп 2 и 5 считают, сколько из первых пяти товаров подходят запросу, а для группы 5 ещё и сколько секунд покупатель ждёт ответа. Для группы 6 проверяют, сообщил ли поиск, что точного совпадения нет, и подходят ли показанные замены. Отдельно считают долю запросов, по которым поиск показал похожий товар вместо нужного. Правило счёта дано в разделе о доле замен ниже. Доля кликов по результатам поиска такую оценку не заменяет. Команда Lamoda прямо пишет, что «клики не гарантируют того, что результаты поиска были максимально релевантными».
Пять позиций - это условная граница первых строк результатов, которую я выбрал для простоты счёта. Lamoda оценивает 60 первых товаров, в кейсе Технопарка использовали метрику nDCG.
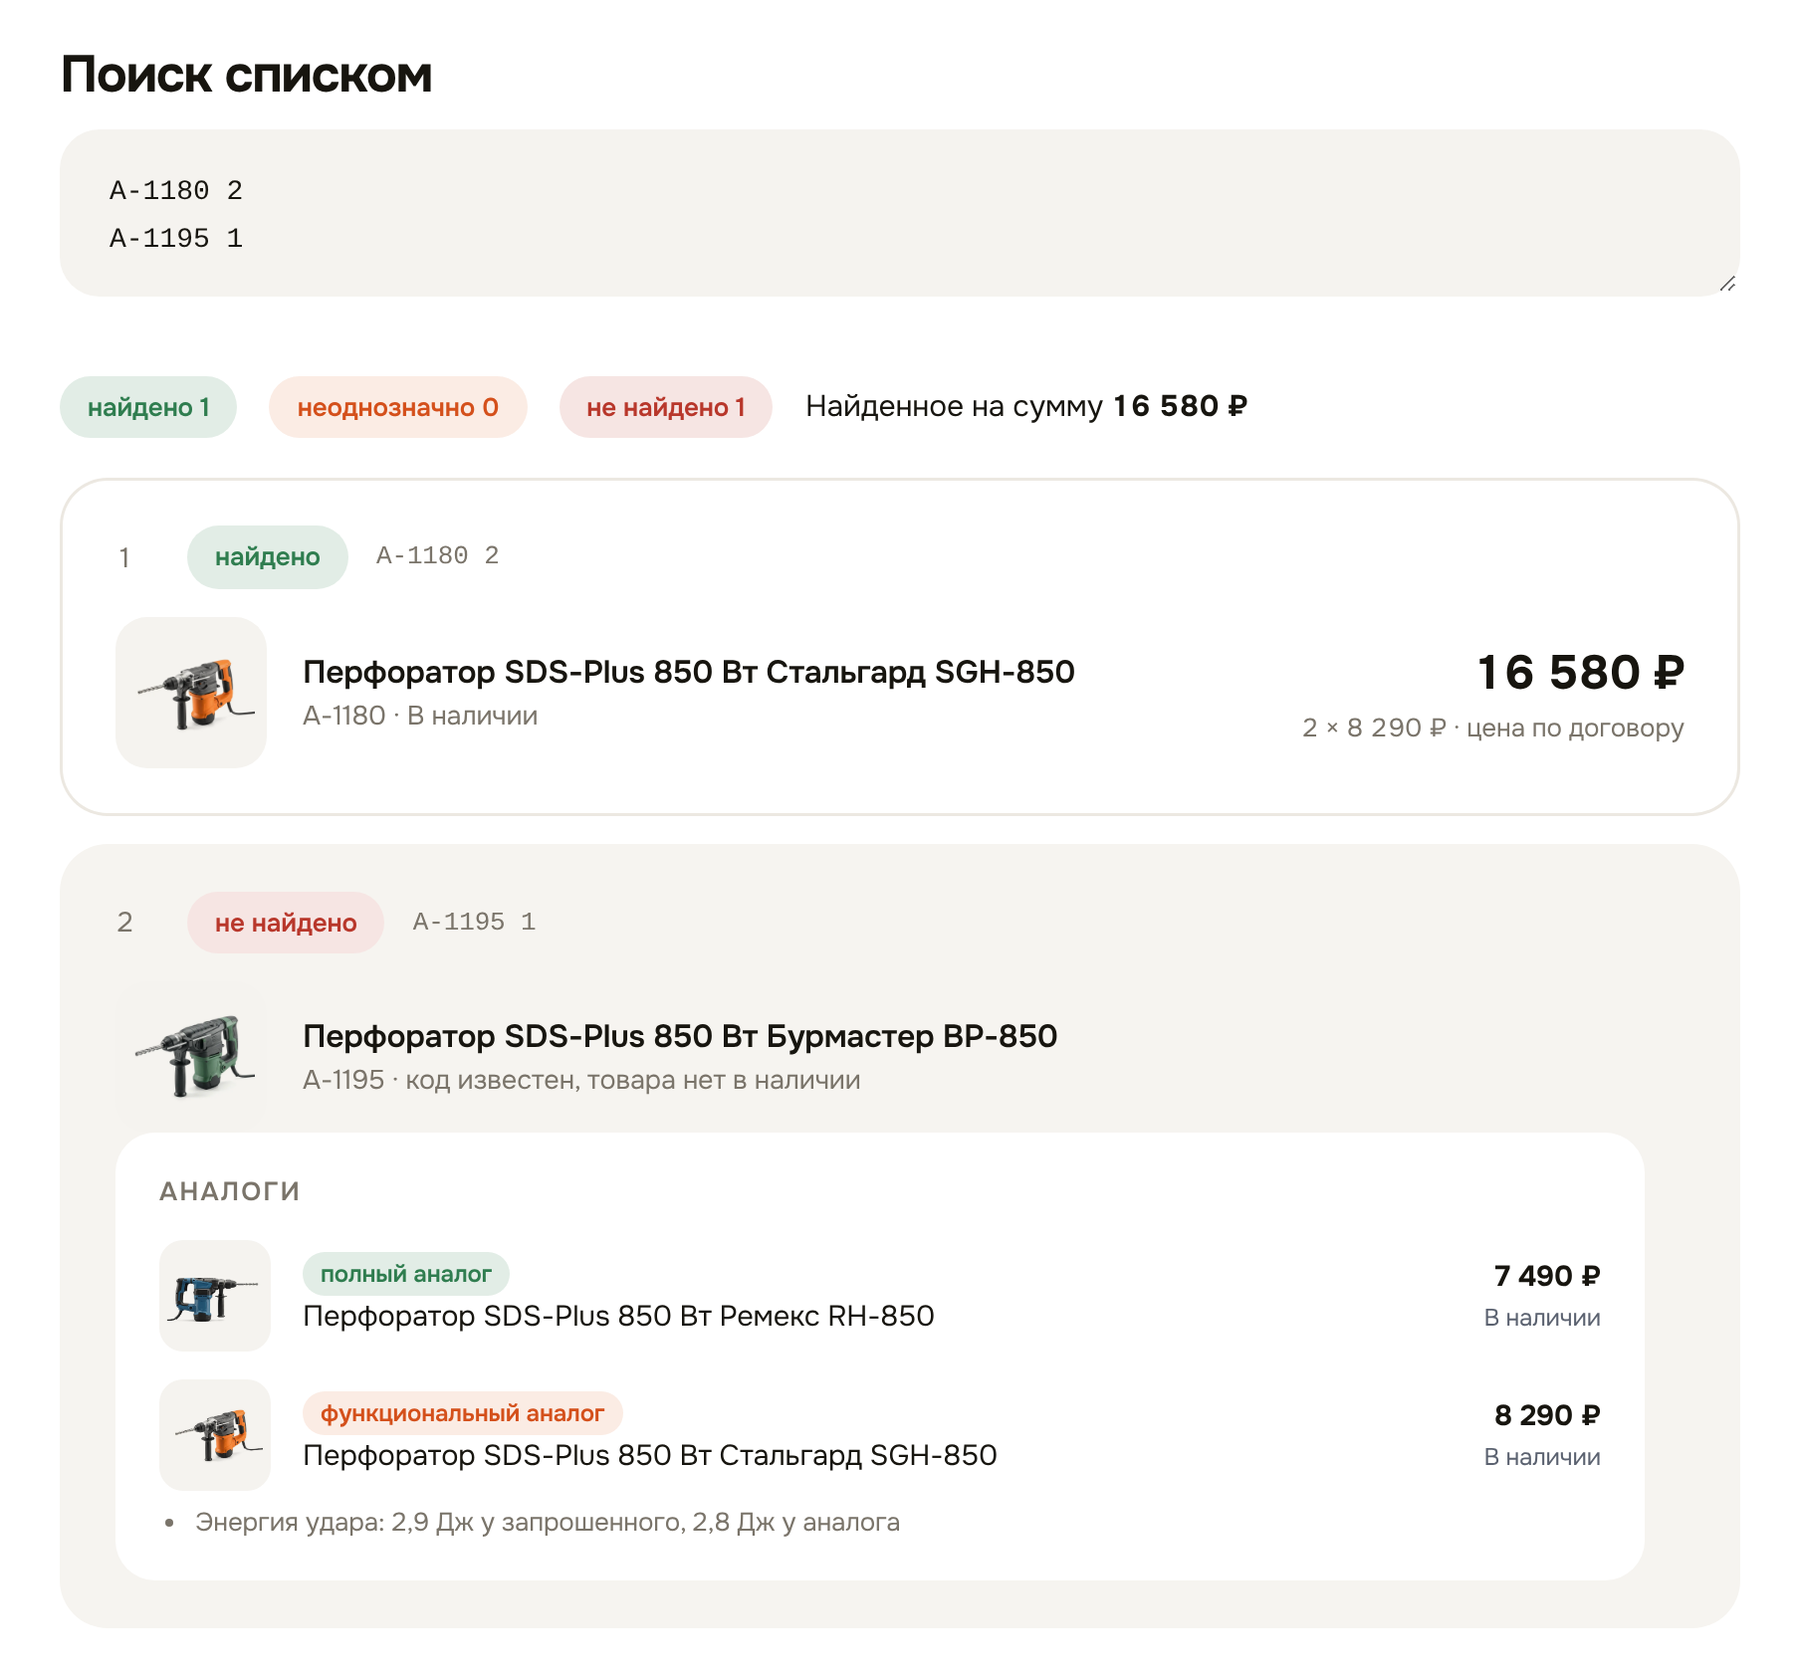
Как посчитать долю запросов, по которым поиск показал похожий товар вместо нужного
Долю таких запросов, дальше доля замен, я бы считал по запросам, для которых на шаге 2 правильным ответом отмечен один конкретный товар, который есть в каталоге и в наличии. Чаще всего это запросы групп 1, 3 и 4. Широкие запросы из этих групп, вроде «tv», считают вместе с группой 2, а запрос о товаре, которого нет в наличии, вместе с группой 6. Запрос попадает в долю замен, если нужного товара нет среди первых пяти результатов, а другие товары показаны, похожие они или нет. Запросы, по которым поиск не показал ничего, остаются в знаменателе, но в долю замен не входят, их считают в доле запросов без результатов. Похожее правило разметки у сервиса YoloPrice, где «похожий, но другой» товар считается нерелевантной позицией.
Доля замен = число запросов, где вместо нужного товара показаны другие / число всех запросов о конкретном товаре из каталога
Например, из 300 таких запросов у 240 нужный товар стоит среди первых пяти результатов, у 15 поиск не показал ничего, у оставшихся 45 нужного товара среди первых пяти нет и показаны другие. Тогда доля замен составит 15%, доля запросов без результатов 5%. Затем по тем же 45 запросам смотрят, сообщил ли поиск покупателю, что точного совпадения нет. О заменах без такого сообщения покупатель может не узнать. Запросы группы 6 и запросы о товаре, которого нет в наличии, считают отдельно. Замена там допустима, и проверяют только, сообщил ли о ней поиск и подходят ли показанные товары.
Ниже авторский образец того, что проверять в каждой группе. Примеры запросов, кроме последней строки, взяты из источников, упомянутых в статье.
| Группа запросов | Пример | Что проверить |
|---|---|---|
| 1. Опечатки, раскладка, латиница | «рибок», «reeboc» | Нужный товар стоит первым или хотя бы среди первых пяти, как и при правильном написании |
| 2. Синонимы, бытовые названия, смежные товары | «штаны» и «брюки», «дегидратор» | Сколько из первых пяти товаров относятся к нужной категории, без аксессуаров и смежных товаров |
| 3. Артикулы и номера моделей | «4 517» для товара с артикулом «-D04517» | Нужный товар стоит первым или хотя бы среди первых пяти |
| 4. Сокращения, единицы, символы | «tv» и «television» | Нужный товар стоит первым или хотя бы среди первых пяти, как и при полном написании |
| 5. Запросы-задачи и отрицания | «что-нибудь тёплое на осень в офис», «платье не из хлопка» | Сколько из первых пяти товаров подходят и сколько секунд ждать ответа |
| 6. Товара нет в ассортименте | бренд или модель, которых нет в каталоге | Сообщает ли поиск, что точного совпадения нет, и подходят ли показанные замены |
Кроме прогона набора, поставщику стоит задать вопросы на четыре темы:
- Через сколько минут новый товар, новая цена и изменившийся остаток видны в поиске по словам и в поиске по смыслу? Найдёт ли поиск по смыслу товар с новым названием или новым брендом без дообучения ML-модели? Сроки у сервисов разные. У ResoSearch поисковый индекс, то есть подготовленная база для поиска, обновляется каждые четыре часа или каждый час в зависимости от тарифа (по разделу тарифов на странице сервиса на 24 октября 2026 года). Retail Rocket Group на странице своего сервиса поиска обещает синхронизацию остатков в реальном времени.
- Что показывает поиск, когда поиск по словам и поиск по смыслу дают разные ответы? Для каких запросов подключается LLM, в основной строке поиска или в отдельном блоке, и сколько секунд покупатель ждёт её ответа? В том же исследовательском проекте (апрель 2026 года) алгоритм с несколькими вызовами LLM для сложных запросов занимал 10-15 секунд, автор считает, что задержку можно снизить до 2-3 секунд.
- Как будет измерен эффект нового поиска в деньгах? Ответ даёт A/B-тест, где часть посетителей видит прежний поиск, а часть новый. В статье об A/B-тестах поиска на сайте any советуют проводить тесты не меньше недели и менять один элемент за раз. Стоит смотреть, какие показатели публикуются по итогам теста. В кейсе Yves Rocher (март 2026 года), бренда косметики с собственным интернет-магазином, команда any после смены шаблона интерфейса поиска провела четырёхнедельный A/B-тест. В кейсе сказано, что доля сессий с поиском выросла на 12%, доля заказов через поиск на 4,8% и доля выручки через поиск на 4,1%. Проценты это или процентные пункты, в кейсе не уточнено. Общая выручка магазина в кейсе не публикуется. Рост доли выручки через поиск сам по себе не доказывает роста всей выручки, часть покупателей могла перейти в поиск из каталога и фильтров. Зачем при расчёте эффекта нужна контрольная группа, коротко сказано в статье о расчёте окупаемости внедрения ИИ.
- Что учитывает порядок результатов, кроме слов запроса и фильтров покупателя? Это может быть история конкретного покупателя, общая популярность товаров, выбор других покупателей по тому же запросу или регион покупателя. От ответа зависит, нужно ли магазину описывать поиск в правилах применения рекомендательных технологий.
Когда умный поиск на сайте подпадает под закон о рекомендательных технологиях
Статья 10.2-2 закона «Об информации, информационных технологиях и о защите информации» (149-ФЗ) касается владельцев сайтов, где информация предоставляется «на основе сбора, систематизации и анализа сведений, относящихся к предпочтениям пользователей». Такой владелец обязан сообщать посетителям о применении рекомендательных технологий, разместить на сайте правила их применения, адрес электронной почты и своё наименование. Слова «поиск» в статье нет.
За первое нарушение этих требований статья 13.56 КоАП предусматривает штраф для юридического лица от 500 до 700 тысяч рублей. Статью ввёл закон 199-ФЗ, опубликованный 26 июня 2026 года. Своей даты вступления в силу в нём нет, поэтому по общему правилу он действует через десять дней после опубликования, с 7 июля 2026 года.
Роскомнадзор в информации от 29 сентября 2023 года указал, что требования закона не распространяются на сайты, где информация предоставляется «исключительно по итогам обработки заданных пользователем поисковых параметров, в том числе с применением фильтров, настраиваемых самим пользователем». Исключение касается сайта целиком. Если на сайте магазина уже есть, например, блок рекомендаций по истории просмотров, правила применения рекомендательных технологий ему по тексту разъяснения нужны в любом случае. Тогда вопрос о поиске сводится к тому, нужно ли описать в этих правилах и его.
Официального разъяснения именно о поиске на сайте найти не удалось. В блоге веб-студии MIKHAILOV studio на Sostav, издании о рекламе и маркетинге, сказано, что к сведениям о предпочтениях «могут относиться» в том числе «поисковые запросы внутри сайта». «Обычный поиск, фильтры и сортировка сами по себе не относятся к рекомендательным технологиям», - написано там же. Юрист в статье на Хабре отвечает на вопрос, нужно ли уведомление для блока «популярное». «Если блок формируется автоматически с учетом поведения пользователей - да», - пишет он. Как эти мнения соотносятся с тем, что учитывает порядок результатов, показано в таблице. Оценки в ней мои.
| Что учитывает порядок результатов | Что известно и моя оценка |
|---|---|
| Только слова запроса и фильтры, которые задал покупатель | в блоге на Sostav обычный поиск, фильтры и сортировка сами по себе к рекомендательным технологиям не отнесены |
| История конкретного покупателя | по моей оценке, ближе всего к определению закона |
| Общая популярность товаров или выбор других покупателей по тому же запросу | зависит от поведения людей; по мнению юриста на Хабре, уведомление нужно для блока «популярное», если он формируется автоматически с учётом поведения пользователей, но сказано это об отдельном блоке |
| Регион покупателя | в найденных публикациях отдельно не разобран |
Вопрос о конкретной настройке поиска я бы решал вместе с юристом. Обязанным закон называет владельца сайта, то есть магазин.
С чего начать пилот умного поиска для интернет-магазина
Начать я рекомендую с выгрузки журнала поиска за последние месяцы. Размеченный по группам набор запросов пригодится для сравнения любых поставщиков и останется у магазина для проверки поиска после каждой крупной настройки.
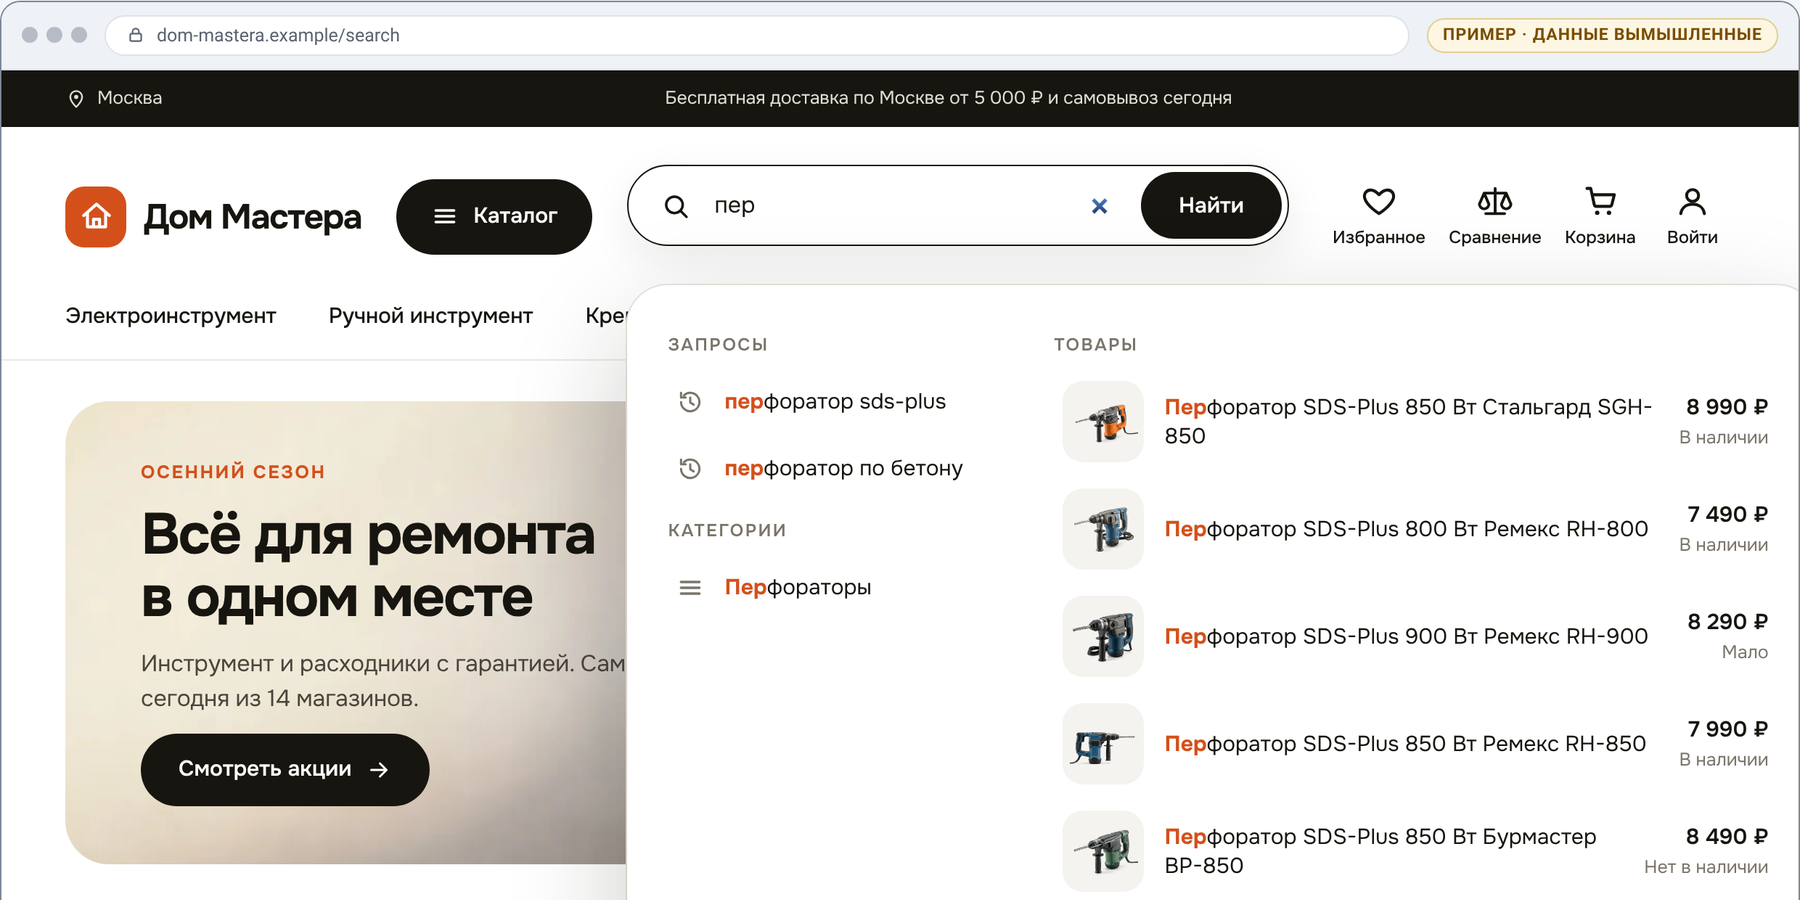
Часть этой проверки автоматизирует наш продукт Svaya.Каталог товаров. Это отдельный продукт со своей лицензией, в лицензию нашей ИИ-платформы Svaya он не входит. Магазин ставит его на своих серверах или в арендованном облаке. Когда точных совпадений нет, продукт по умолчанию тоже показывает похожие товары и называет, какие условия запроса ослабил, а если похожих нет, показывает до двенадцати популярных товаров той категории, где искал покупатель. Показ похожих и популярных товаров можно выключить в настройках. Паспорт качества продукта (экран и отчёт) измеряет поиск на наборе запросов, который загружает магазин, и показывает долю пустых поисковых выдач, долю запросов, где нужный товар попал в первую пятёрку, устойчивость к опечаткам и время ответа. Если загрузить результаты действующего поиска магазина, рядом видно и их качество. Сравнение с поиском других поставщиков на странице продукта не описано. В отчёте «Что ищут и не находят» продукт показывает и запросы, на которые не нашлось точных товаров, но доли таких запросов в перечне метрик паспорта на странице продукта нет. Экраны в этой статье сняты с кликабельного макета продукта, магазин и данные в нём придуманы. Одна из метрик, которые я предлагаю в этой статье, есть ли нужный товар среди первых пяти результатов, совпадает с метрикой нашего паспорта. Раз статья продвигает метрику, которую считает наш продукт, его стоит проверять тем же набором запросов, что и любого другого поставщика, и задать нам те же вопросы. Поиск в продукте можно оценивать 30 дней бесплатно от первого запуска.