Какие задачи российские компании уже отдали большим языковым моделям (LLM) и что из этого получили, проще всего узнать по публичным кейсам. Мы собрали 23 таких кейса 2024-2026 годов, в которых опубликован результат в числах, и в ноябре 2026 года сверили каждое число со страницей, где оно опубликовано.
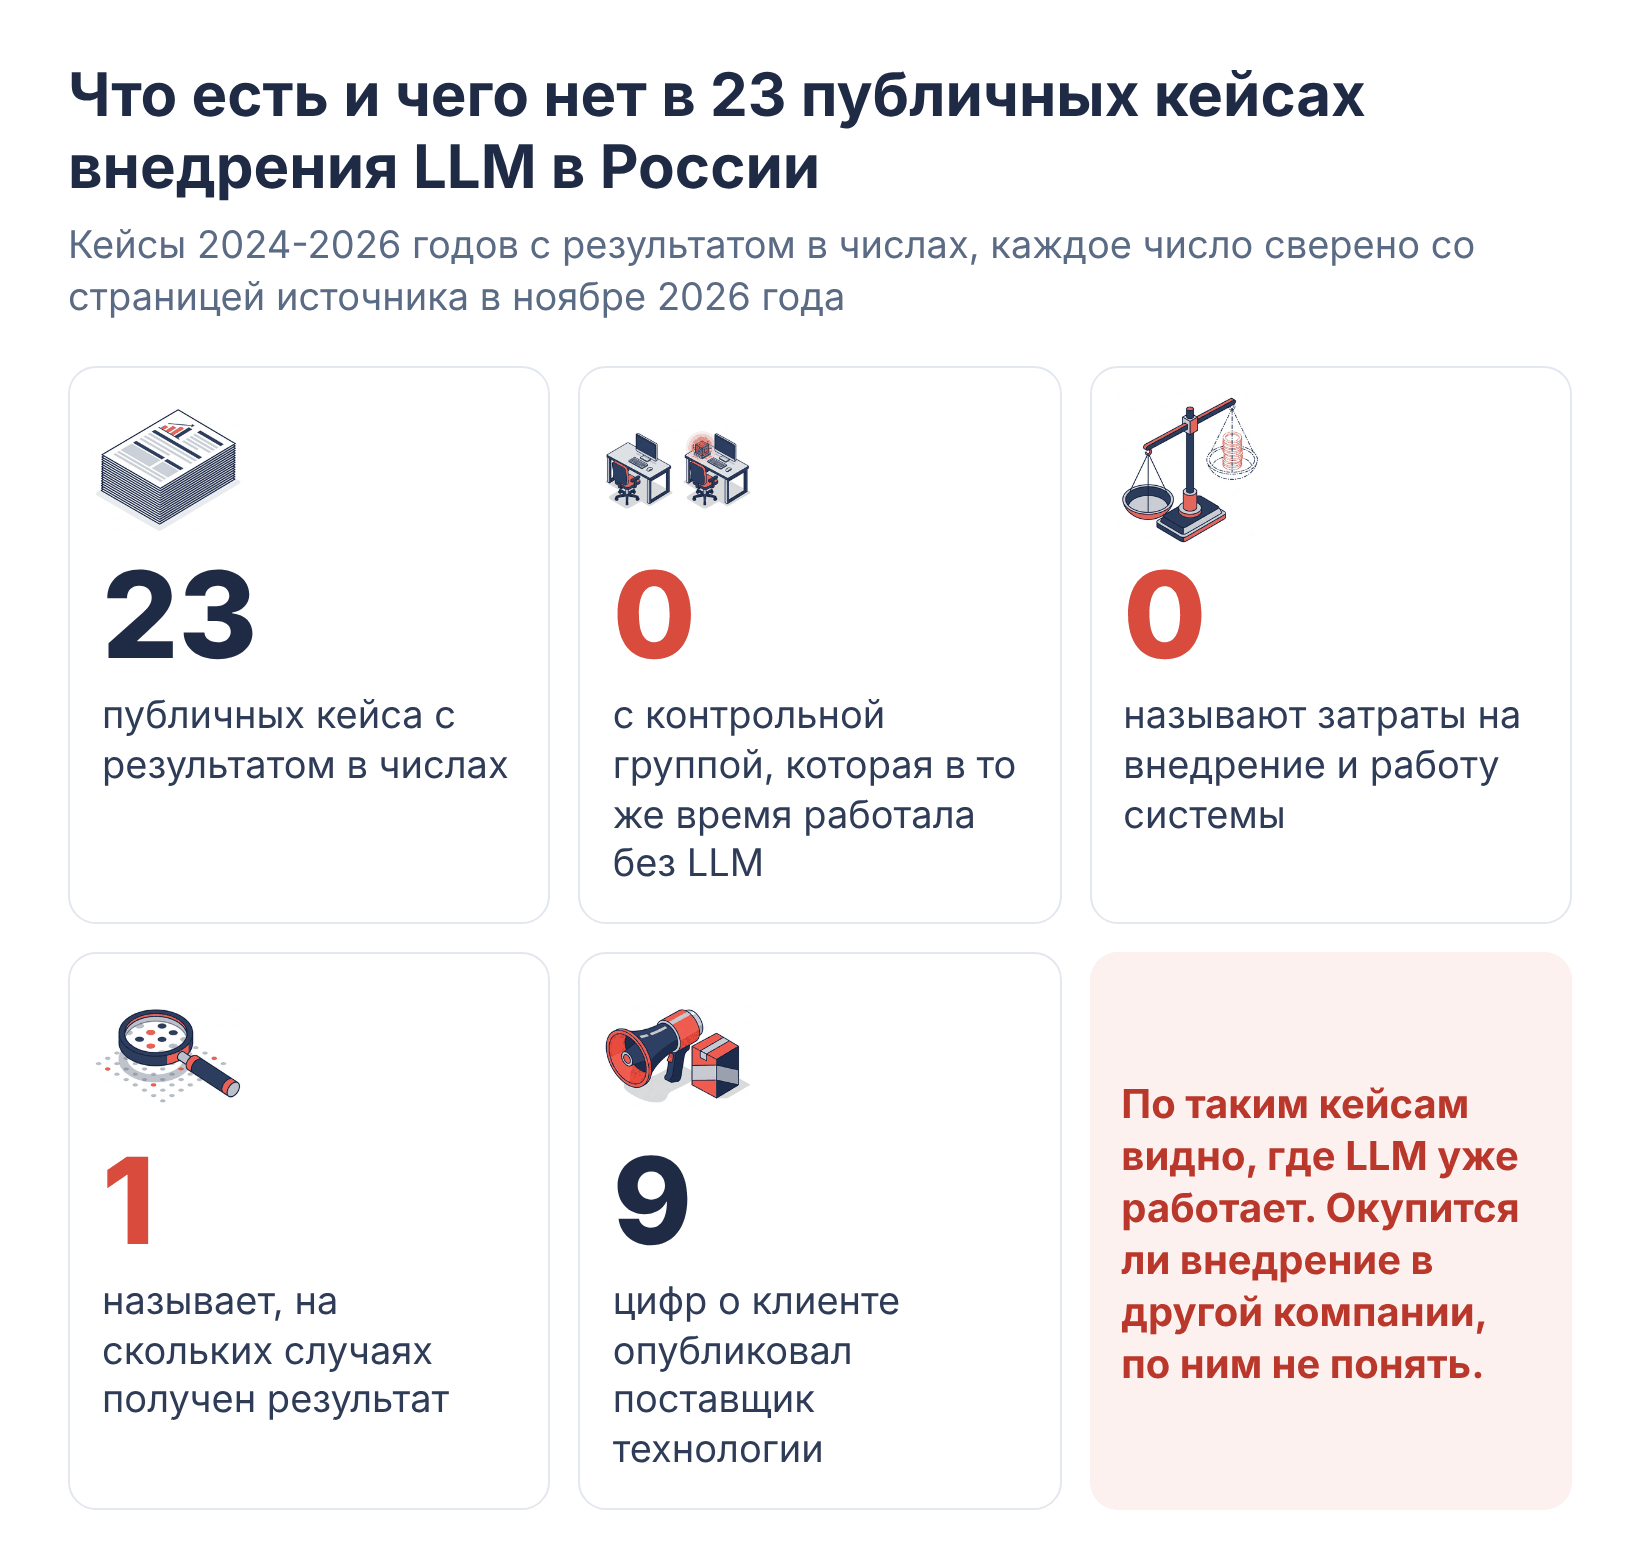
Обычно подрядчик или коллега приносит кейс с цифрой на совещание как довод, что у другой компании LLM сэкономила часы или деньги и, значит, сэкономит их и у компании, которая этот кейс читает. По кейсам хорошо видно, в каких задачах LLM уже работает. А вот перенести цифру из кейса на свою компанию по ним нельзя, и сводка ниже показывает почему.
Поэтому, на наш взгляд, публичный кейс стоит читать как карту задач, о которых компании охотно рассказывают, а эффект для своей компании считать на своём пилоте. Ниже по порядку цифры исследования СберПро и TAdviser, с которого мы начали, кейсы по отраслям, четыре признака, по которым цифре можно доверять, наши собственные кейсы и вопросы к подрядчику.
С чего мы начали подборку кейсов LLM и какие цифры исследования СберПро и TAdviser нашлись в первоисточниках
Подборку мы начали с исследования СберПро (медиа Сбера) и аналитического центра TAdviser «Генеративный ИИ в России: особенности, проблемы, тренды», вышедшего в конце октября 2026 года. Мы взяли из него восемь кейсов семи компаний с цифрами эффекта языковых моделей. У каждой цифры в исследовании в скобках назван источник, и мы поискали эти цифры в первоисточниках.
| Кейс из исследования | Цифра | Где мы её нашли |
|---|---|---|
| Альфа-Банк, валютный контроль | с двух часов до минуты на договор, точность около 80% | сообщение банка в ComNews |
| Совкомбанк, чат-бот для сотрудников | 310 тыс. часов рабочего времени сотрудников в год | только на сайте медиа Just AI, поставщика платформы; в пресс-релизе банка этих часов нет |
| КНАУФ, ассистент для клиентов | точность 89% и экономия «до 50% рабочего времени» | 89% в анонсе вебинара Just AI на Хабре, 50% не нашли |
| Сбер, весь банк | не менее 50 млрд руб. эффекта за 2025 год | только в пересказе инвестиционного издания Investfuture |
| ВТБ | около 80% обращений в чате решаются автоматически | не нашли |
| Ростелеком | 50% обращений в чате обрабатывается автоматически | не нашли |
| СберМобайл | 6 из 10 обращений без оператора | не нашли |
| Альфа-Банк, платформа AlfaGen | автотесты создаются на 70% быстрее | не нашли, в публикации об автотестах банка на Хабре этого числа нет |
Цифры Р-Фарм (генеративная молекулярная модель для поиска лекарств) и цифры Ростелеком Контакт-центра о распознавании и синтезе речи мы не брали, потому что к языковым моделям они не относятся.
Ненайденные цифры при этом могут быть верны. Мы говорим только о том, что в открытых источниках их не нашли. Само исследование о публично заявленном эффекте проектов генеративного ИИ пишет, что он «систематически не подтверждается» и что «при полной оценке стоимости владения эффект оказывается существенно меньше обещанного».
Публичные кейсы LLM по отраслям
В каждой таблице столбец «Сравнение» показывает, что опубликовано (оба значения «было и стало», только изменение или без сравнения), а столбец «Кто опубликовал» показывает, чья это цифра. Оговорки к цифрам стоят под таблицей.
Банки (6 кейсов)
| Компания | Что делает LLM | Результат | Сравнение | Кто опубликовал | Источник |
|---|---|---|---|---|---|
| Альфа-Банк | ИИ-агент разбирает внешнеторговые договоры для валютного контроля | 1 минута на договор вместо «до 2 часов», точность 80% при плановых 60% | было и стало | банк | ComNews, 20.02.2026 |
| Альфа-Банк | ИИ-агенты пишут и проверяют автотесты для ПО | на 30% больше найденных ошибок | только изменение | банк | Хабр, 03.03.2025 |
| Азиатско-Тихоокеанский банк | пять ИИ-агентов на GigaChat Enterprise (база знаний, справки о доходах, кадровые вопросы и другие) | эффект более 75 млн руб. за год, время на повторяющиеся задачи меньше в среднем на 70-80% | только изменение | поставщик (реклама Сбербанка) | «Амурская правда», 20.05.2026 |
| Совкомбанк | чат-бот отвечает сотрудникам по базе знаний | точность ответов с 72% до 89% за 5 месяцев, экономия 310 тыс. часов рабочего времени в год | было и стало | поставщик (медиа Just AI) | Generation AI, 03.11.2025 |
| ОТП Банк | речевая аналитика во взыскании | разбор диалога экспертом 20 секунд вместо 7 минут, корректность оценки более 99%, обещаний оплаты больше на 5,5% | было и стало | поставщик (Naumen) | Naumen, 25.03.2026 |
| Сбер | GigaChat в процессах банка | эффект почти 30 млрд руб. за первое полугодие 2025 года | без сравнения | разработчик LLM о себе | ComNews, 30.07.2025 |
- Альфа-Банк, валютный контроль. Агент работает на платформе банка AlfaGen, и что это LLM-платформа, сказано в исследовании СберПро и TAdviser. «До 2 часов» - это верхняя граница, на скольких договорах мерили, не сказано.
- Альфа-Банк, автотесты. В публикации сказано, что «нейросети создают автотесты», цифру назвал директор банка по генеративному ИИ в ИТ. Это пилот в нескольких продуктовых командах.
- Азиатско-Тихоокеанский банк. Ещё один агент проверяет документы корпоративных клиентов, другой расшифровывает аудио и видео. Материал с пометкой «Реклама» Сбербанка, разработчик платформы входит в группу Сбер. Исходное время не названо.
- Совкомбанк. Материал подписан командой банка и вышел на сайте медиа Just AI. Как получены часы, не раскрыто, в пресс-релизе банка их нет. Более 90 тыс. запросов к чат-боту показывают, сколько им пользовались, а на каком наборе считали точность, не сказано.
- ОТП Банк. Это пересказ выступления сотрудников банка у поставщика. Классическое машинное обучение оценивает все звонки, LLM подключается там, где нужно понимание контекста. Время разбора сократилось «благодаря саммаризации диалога», кто её делает, не сказано, остальные цифры относятся к системе в целом. Корректность оценки посчитана по 7 критериям из 8, с чем её сверяли и за какой срок, не сказано.
- Сбер. Это итог по всему банку, как считали, не раскрыто. Цифру из исследования, не менее 50 млрд руб. за 2025 год, мы нашли только в пересказе, а почти 30 млрд руб. за полугодие банк называл сам.
Ритейл и электронная торговля (5 кейсов)
| Компания | Что делает LLM | Результат | Сравнение | Кто опубликовал | Источник |
|---|---|---|---|---|---|
| Яндекс Маркет | YandexGPT пишет описания товаров для продавцов | продавцы используют 52% описаний, продаж больше на 1,1%, без ошибок 88 текстов из 100 (до дообучения нейросети ошибались в 33-35 из 100) | было и стало | разработчик LLM о себе | Yandex Cloud, 29.08.2024 |
| Лемана ПРО (рассказывает ИТ-компания «Лемана Тех») | LLM пишет описания товаров, финальный текст проверяет сотрудник | описание за секунды вместо «до двух недель», бюджет на контент ниже на 95% | только изменение | компания (выступление в пересказе) | Retail.ru, 30.04.2025 |
| Лемана ПРО | речевая аналитика проверяет этапы продаж в звонках контакт-центра | точность оценки выше 90%, соблюдение скриптов с 41 до 94%, заказы по телефону с 12 до 15% | было и стало | поставщик (3iTech, реклама) | Retail.ru, 03.06.2026 |
| Магнит Omni | генеративный ИИ готовит карточки товаров в приложении | время сотрудников на подготовку материалов меньше на 10-15% | только изменение | компания (выступление в пересказе) | Retail.ru, 30.04.2025 |
| Авито | продукты на генеративном ИИ, запущенные в 2024 году | 670 млн руб. выручки в год | без сравнения | компания | Sostav, 31.03.2025 |
- Яндекс Маркет. За полгода продавцы сгенерировали с помощью YandexGPT более двух миллионов описаний. Как измерен рост продаж, не описано.
- Лемана ПРО, описания товаров. Время проверки сотрудником в «секунды» не входит, объём и срок не названы.
- Лемана ПРО, звонки. «Было» мерили вручную на 1,5% звонков, «стало» автоматически на всех. В описании нынешней системы LLM упомянута только во вступлении к интервью. Другие причины роста продаж не отделены.
- Авито. Какие продукты дали выручку и как её отнесли к ИИ, не сказано.
Телеком (3 кейса)
| Компания | Что делает LLM | Результат | Сравнение | Кто опубликовал | Источник |
|---|---|---|---|---|---|
| МегаФон | ИИ-ассистент продавцов салонов связи | продавцы выходят на план на 15% быстрее, текучесть ниже на 8,5% | только изменение | компания | пресс-релиз на площадке Spark, 22.09.2026 |
| Ростелеком Контакт-центр | LLM помогают операторам и проверяют их работу | клиенты получают ответ в 7 раз быстрее, производительность операторов выше на 21% | только изменение | компания и поставщик (3iTech) | ComNews, 25.03.2025 |
| Билайн | «ИИ-инженер» разбирает инциденты на сети связи | около 15 тыс. запросов за два с небольшим месяца пилота, решение по инциденту в среднем за 3 минуты | без сравнения | компания | ComNews, 20.03.2026 |
- МегаФон. Что ассистент работает на LLM, писал ComNews 15.07.2025. С чем сравнивали и за какой срок, не сказано. Результаты оценивало жюри отраслевой премии по заявке компании.
- Ростелеком Контакт-центр. Это дочерняя компания Ростелекома, цифры относятся к 2024 году и к речевой аналитике вместе с LLM.
- Билайн. Ускорение взятия инцидента в работу в 2 раза названо прогнозом.
Девелопмент (2 кейса)
| Компания | Что делает LLM | Результат | Сравнение | Кто опубликовал | Источник |
|---|---|---|---|---|---|
| ГК ФСК | два ассистента, один отвечает подрядчикам на сайте, другой помогает сотрудникам отвечать покупателям | нагрузка на поддержку и коммерческий департамент ниже на 30-40%, точность «до 90-98%» | только изменение | поставщик (red_mad_robot) | Workspace, кейс red_mad_robot |
| ГК «А101» | ассистент ищет ответы для сотрудников по Confluence, 1С и рабочим папкам | ответ в среднем за 20 секунд против более минуты у сотрудников, «достоверность» ответов 92% | было и стало | поставщик (red_mad_robot) | RUWARD AWARD 2026 |
- ГК ФСК. На той же странице точность названа ещё дважды и по-другому (96% и «до 95-100%»). Дата публикации не указана, на скольких ответах проверяли точность, не сказано.
- ГК «А101». Скорость сравнивали с сотрудниками на внутреннем конкурсе. Метрика «достоверность» показывает, насколько ответ опирается на найденные документы, оценку ставила другая LLM, сколько было эталонных ответов, не сказано.
Промышленность (2 кейса)
| Компания | Что делает LLM | Результат | Сравнение | Кто опубликовал | Источник |
|---|---|---|---|---|---|
| Норникель | несколько ИИ-агентов проектируют промышленные здания | задания на проектирование готовят на 83% быстрее, проектная команда 5-7 человек вместо 15-25 | было и стало | компания | ComNews, 15.05.2026 |
| КНАУФ (производство стройматериалов) | ассистент отвечает клиентам по продуктам компании | точность ответов до 89% | без сравнения | поставщик (Just AI) | Хабр, 17.02.2025 |
- Норникель. Это пилот, число объектов не названо.
- КНАУФ. Число взято из анонса вебинара поставщика, как мерили точность, не сказано.
Госсектор (2 кейса)
| Компания или ведомство | Что делает LLM | Результат | Сравнение | Кто опубликовал | Источник |
|---|---|---|---|---|---|
| Минфин России | ИИ-агент на GigaChat помогает оценивать заявки ведомств, решение остаётся за экспертами министерства | нагрузка на сотрудников в пиковые периоды ниже «в ряде случаев до 70%» | только изменение | ведомство (слова министра в пересказе) | Хабр, 29.06.2025 |
| Росагролизинг | LLM-сервис помогает работать с договорами лизинга, номенклатурой техники и субсидиями | время на работу с документами меньше «до 50%», это прогноз | только изменение | компания и разработчик | ComNews, 24.06.2026 |
- Минфин России. «В ряде случаев до 70%» - это верхняя граница отдельных случаев, среднее не названо.
- Росагролизинг. Других чисел нет, фактический эффект, по словам разработчика, будет уточняться.
Страхование, ремонт техники и автодилер (3 кейса)
| Компания | Что делает LLM | Результат | Сравнение | Кто опубликовал | Источник |
|---|---|---|---|---|---|
| Росгосстрах | генеративный ИИ разбирает все входящие звонки | средняя длительность разговора ниже примерно на 7% | только изменение | компания | CNews, 22.06.2026 |
| Ленремонт (ремонт бытовой техники) | LLM разбирает диалоги с клиентами и отмечает отклонения для контроля качества | 500 найденных проблемных звонков в день вместо 90, нагрузка на отдел ниже в 10 раз | было и стало | поставщик (интегратор Aiston) | CNews, 18.12.2025 |
| Frank Auto (автодилер) | речевая аналитика на GigaChat оценивает звонки менеджеров | экономия 200 часов в месяц, качество общения с клиентами выше на 20% | было и стало | поставщик (СберПро, медиа Сбера) | СберПро, июль 2026 |
- Росгосстрах. С чем сравнивали и за какой срок, не сказано.
- Ленремонт. Раньше слушали не больше 5-10% звонков, теперь 99%, поэтому и проблемных звонков находят больше.
- Frank Auto. Раньше на прослушивание уходило «более 200 часов в месяц», а сэкономленные 200 часов источник называет «около 30% рабочего времени специалистов». Кейс известен только в пересказе.
Проверяемого кейса LLM с числом у логистических компаний мы не нашли, хотя LLM там вполне могут применять. Ещё два кейса, которые часто приводят в обзорах, X5 (оценка компетенций продакт-менеджеров) и Т-Банк (ИИ-сотрудник в клиентском обслуживании), в таблицы не вошли, потому что в их публикациях не сказано ни о языковой модели, ни о генеративном ИИ.
Какие результаты LLM называют в публичных кейсах
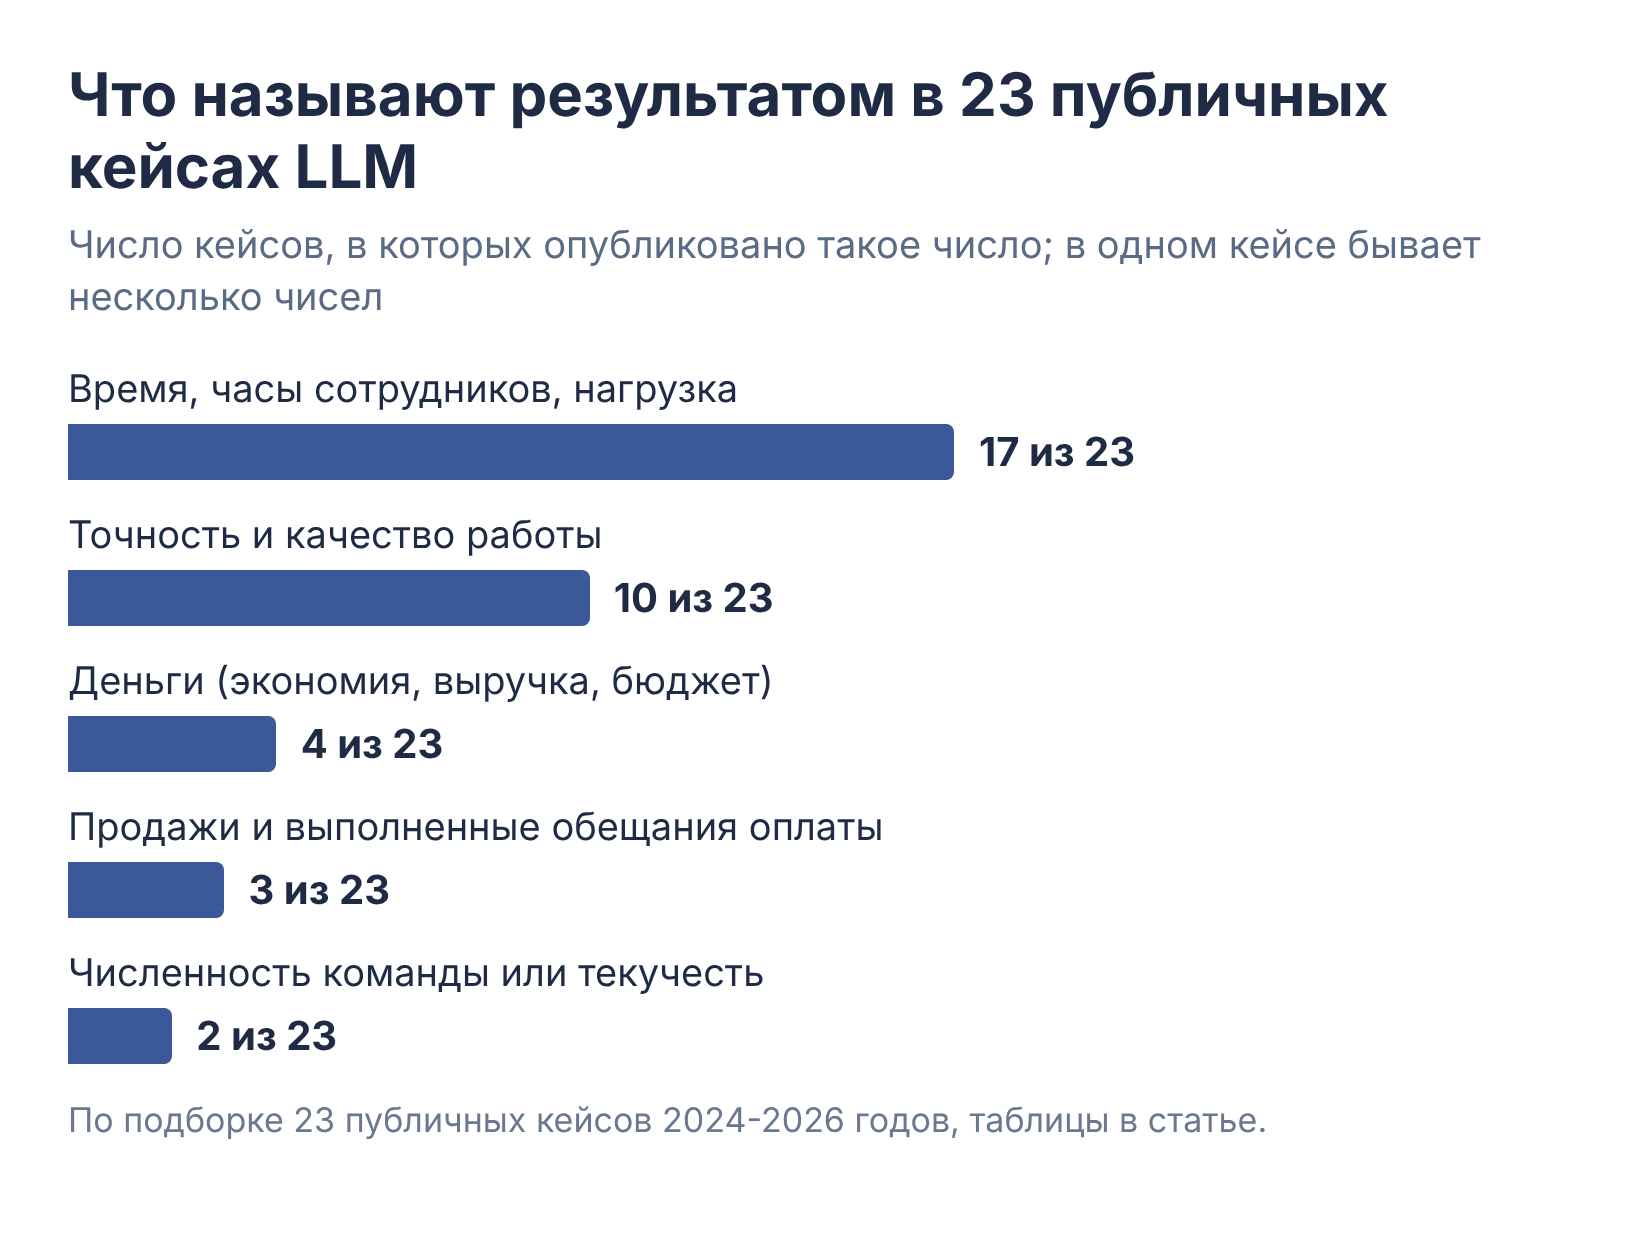
Время и точность проще всего посчитать, но окупаемость внедрения LLM из них сама не следует, и вот почему:
- Сэкономленные часы превращаются в деньги, только если сотрудника перевели на другую работу или не наняли нового.
- Точность 90% ещё не говорит, во что обходятся оставшиеся 10% ошибок.
Как считать окупаемость с учётом того, во что превращаются сэкономленные часы и сколько стоят ошибки, мы писали в статье о расчёте окупаемости внедрения ИИ.
Почему в публичных кейсах LLM о разборе звонков пишут чаще, чем об аналитике и отчётности
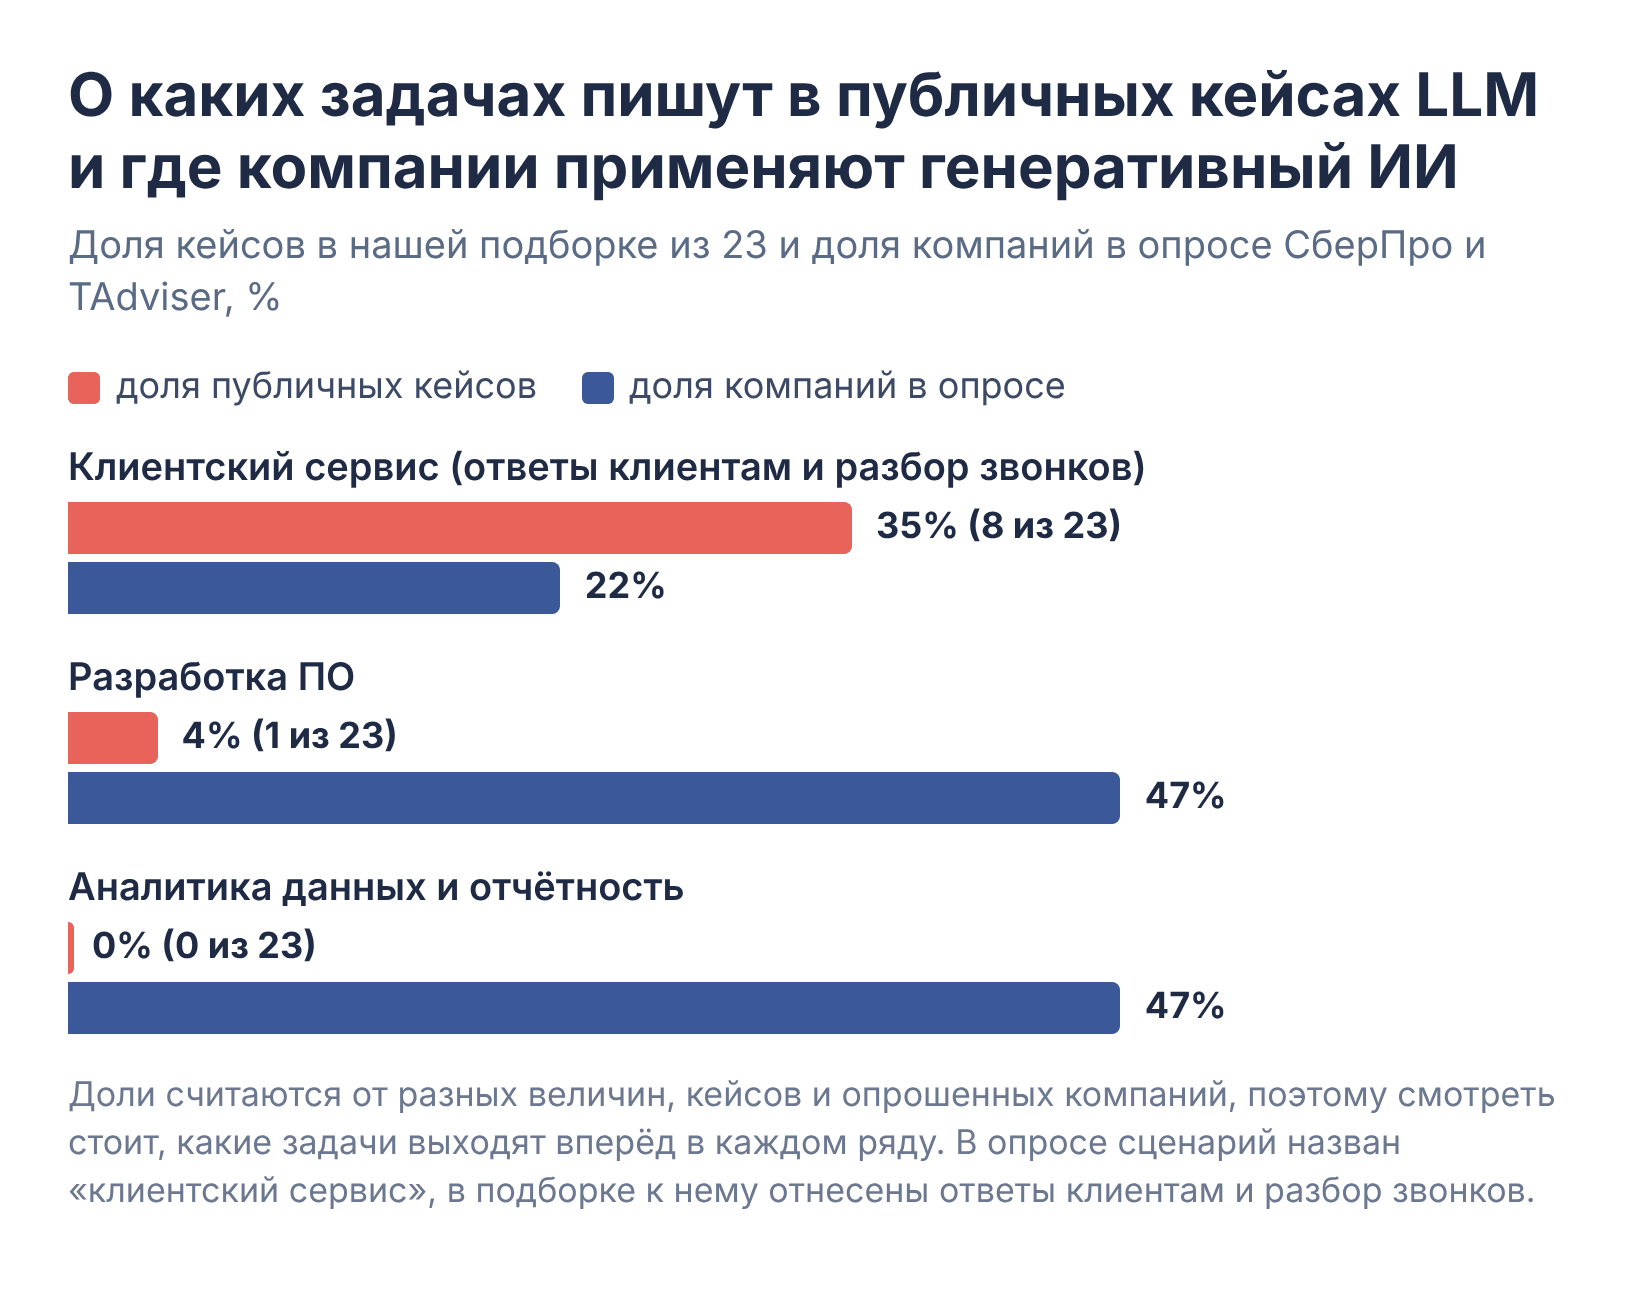
Из 23 кейсов 8 про ответы клиентам и разбор звонков, 2 про работу с договорами, 1 про разработку ПО и ни одного про аналитику и отчётность. В опросе исследования СберПро и TAdviser на вопрос, где уже применяют генеративный ИИ, компании чаще всего называют разработку ПО (47%) и аналитику данных с подготовкой отчётности (47%), а клиентский сервис, по словам авторов, «упомянут лишь в 22% случаев».
Выходит, о клиентском сервисе и разборе звонков в публичных кейсах пишут чаще, чем его называют опрошенные компании, а об аналитике и договорах реже. Объяснение авторы дают сами. Клиентский сервис у них - это «главный витринный сценарий публичного поля», а сценарии, не создающие «поводов для пресс-релиза», вроде работы с договорами, по их словам, распространены «заметно шире, чем принято думать». Значит, если по задачам своей компании, например по отчётности или договорам, публичных кейсов мало, LLM там всё равно могут применять.
Как проверять систему разбора звонков на своих записях, мы писали в статье о пилоте речевой аналитики в контакт-центре.
Четыре признака, по которым цифре из кейса можно доверять
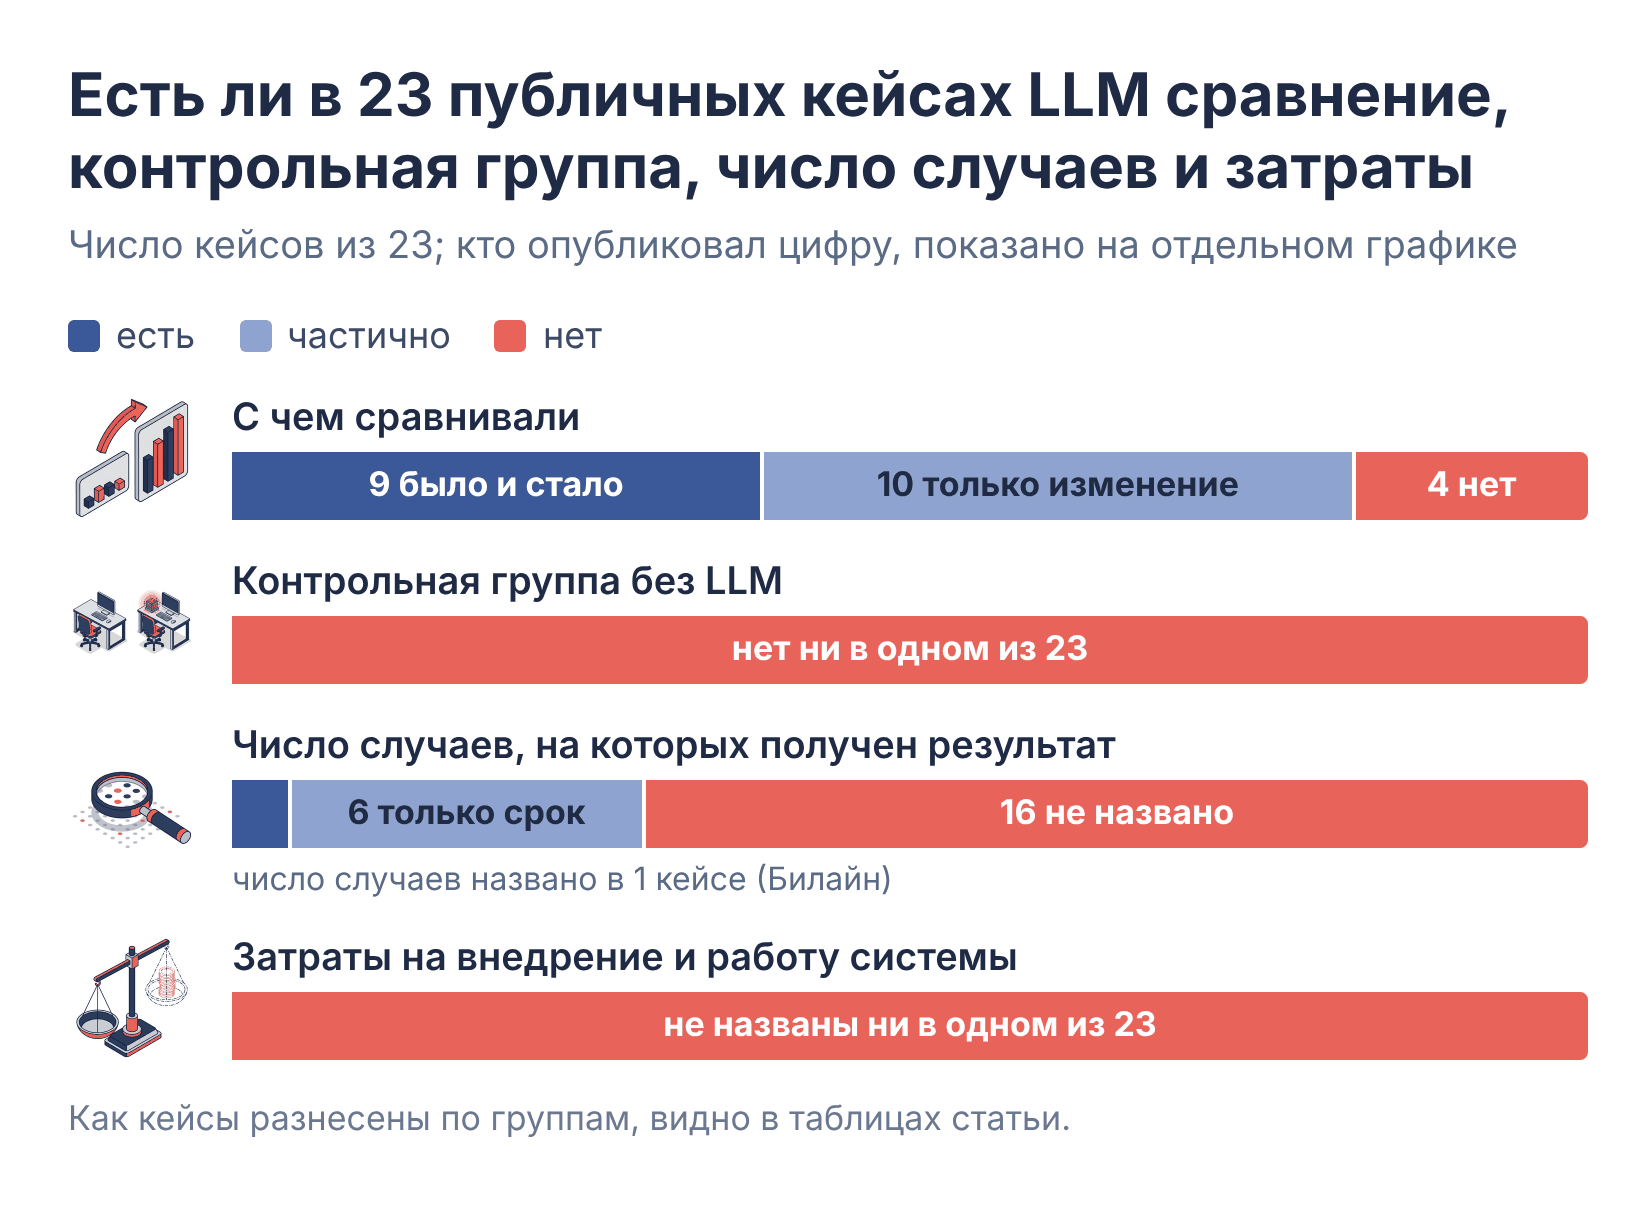
- С чем сравнивали. Оба значения, «было» и «стало», числами есть в 9 кейсах, только изменение («на 70-80%», «в 7 раз») в 10, сравнения нет в 4. Контрольной группы, то есть сотрудников или клиентов, которые в то же время работали без LLM, нет ни в одном. Ближе всего к ней внутренний конкурс А101, где сотрудники искали ответы наперегонки с ассистентом, но так сравнивали только скорость. В 2 кейсах «было» и «стало» мерили разным способом (Лемана ПРО и Ленремонт), в 2 ключевое число названо прогнозом (Билайн и Росагролизинг).
- На скольких случаях и за какой срок. Число случаев видно только у Билайна. Срок или общий объём работы назван ещё у Азиатско-Тихоокеанского банка, Совкомбанка, Сбера, Яндекс Маркета, Авито и Ростелеком Контакт-центра.
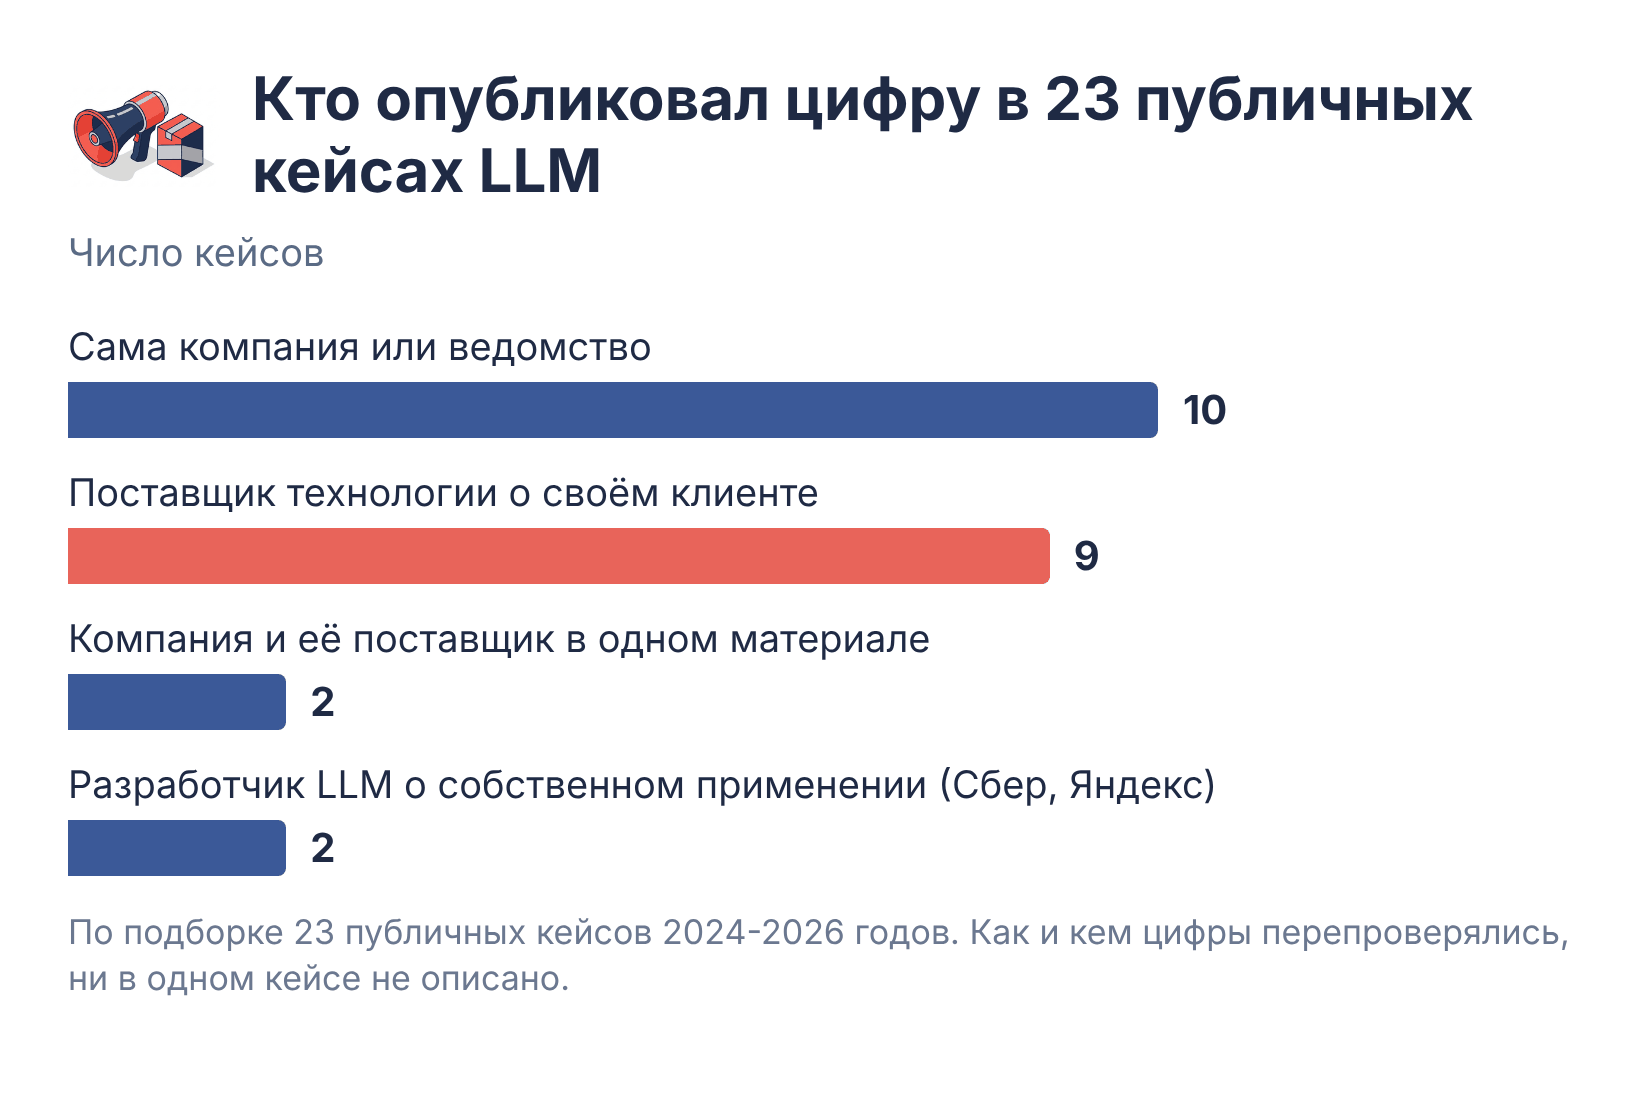
- Кто опубликовал цифру. Девять цифр о клиенте вышли в материалах поставщика технологии (в каталоге кейсов на сторонней площадке, пресс-релизе, конкурсной заявке, анонсе вебинара, на своём медиа или в рекламном материале). Как и кем цифры перепроверялись, в кейсах не описано.
- Сколько стоили внедрение и работа системы. Не названо ни в одном кейсе. У Авито есть только план вложений в генеративный ИИ в целом, около 12 млрд руб.
Без затрат цифра эффекта ничего не говорит о том, окупилось ли внедрение. На конференции ЦИПР-2026 («Цифровая индустрия промышленной России»), как пересказывает деловое издание Инк., директор по ИТ Альфа-Банка рассказал про ИИ-агента в ИТ-поддержке банка. Ответы стали намного быстрее, пользователи были довольны, но когда в банке посчитали стоимость работы языковой модели на реальном объёме обращений, агент оказался дороже живого специалиста (насколько, не сказано).
Многие компании эффект от ИИ не измеряют и для себя. По исследованию ИТ-компании КОРУС Консалтинг среди более чем 80 компаний, о котором писало отраслевое издание Новости ИТ-канала в сентябре 2026 года, 44% компаний вообще не измеряют эффект от внедрения ИИ. Ещё 25% отслеживают отдельные показатели и не связывают их с экономикой бизнеса.
Как наши кейсы LLM отвечают на четыре вопроса о том, можно ли доверять цифре
| Кейс | Результат | С чем сравнивали | Сколько случаев и срок | Кто опубликовал | Затраты |
|---|---|---|---|---|---|
| ИТ-Телеком, поиск по проектной документации на ИИ-платформе Svaya, сентябрь 2026 года | вопросов к техническому руководителю 1-2 в день вместо 5-10 | обе величины по оценке компании | замера не было ни до, ни после | мы, поставщик платформы | не названы |
| Тендерная система, которая с помощью LLM отбирает закупки, июль 2026 года | из 179 закупок недели подходящими нам оказались 5, ещё 9 требовали взгляда человека | сравнение с ручной работой в кейсе само названо неточным | одна неделя, 179 закупок | мы о собственной системе | только подписка на агрегатор закупок, 12 900 руб. за полгода |
- ИТ-Телеком - это компания, которая строит ИТ-инфраструктуру, в ней до 30 человек. Вопросы сотрудников - о том, где найти документ или где компания уже делала похожее. Что замера не было, в кейсе сказано прямо.
- Тендерная система. Закупки той недели разбирал прототип системы. Сколько подходящих закупок он не увидел, мы не измеряли. Цели на первый квартал (40 полных разборов закупок в месяц вместо 12 вручную, 8 поданных заявок вместо 3-4 и ни одного отклонения по формальным причинам) в кейсе названы целями, итоги квартала мы пока не публиковали.
Контрольной группы и проверки посторонним нет и у нас.
Где наша подборка из 23 кейсов LLM может ошибаться
- Мы искали публикации с результатом в числах, поэтому удачных проектов в таблицах больше, чем среди всех внедрений. Все подсчёты относятся только к этим 23 публикациям.
- Все 23 страницы из таблиц мы открыли, но несколько страниц, где могли быть другие кейсы, например в РБК Компании, в ноябре 2026 года не открылись.
- Если компания раскрыла способ замера где-то ещё, например в выступлении на видео, в нашу проверку это не попало.
- Только в пересказе мы знаем пять кейсов, это Минфин, Frank Auto, выступления Леманы ПРО и Магнит Omni, которые описало издание, и выступление сотрудников ОТП Банка, которое пересказал поставщик Naumen.
- Самые старые цифры относятся к 2024 году.
Какие четыре вопроса задать подрядчику, который показывает кейс внедрения LLM с цифрой
- С чем сравнивали? Какое было значение до внедрения, мерили ли «до» и «после» одинаково и работала ли в то же время без LLM группа сотрудников или клиентов, с которой сравнивали?
- На скольких случаях и за какой срок получено число?
- Кто опубликовал цифру, сама компания или поставщик, где её первоисточник и описан ли способ замера?
- Сколько стоили внедрение и работа системы за тот же срок, за который получен эффект?
Если ответов нет, кейс всё равно полезен как пример задачи. Сколько LLM сэкономит компании, которая думает о внедрении, покажет её собственный пилот, устроенный так, чтобы он сам отвечал на эти четыре вопроса:
- Исходное значение замеряют до запуска тем же способом, что и после.
- Часть сотрудников или случаев, если получается, на тот же срок оставляют без LLM.
- О числе случаев, сроке и о том, кто считает результат, договариваются заранее.
- Затраты на внедрение и работу системы за срок пилота записывают вместе с эффектом.
- Правильные ответы для случаев пилота сотрудники записывают заранее, чтобы посчитать долю ошибок.
Как выбрать для пилота первую задачу и где взять правильные ответы, мы писали в статье о том, с чего начать внедрение ИИ.
