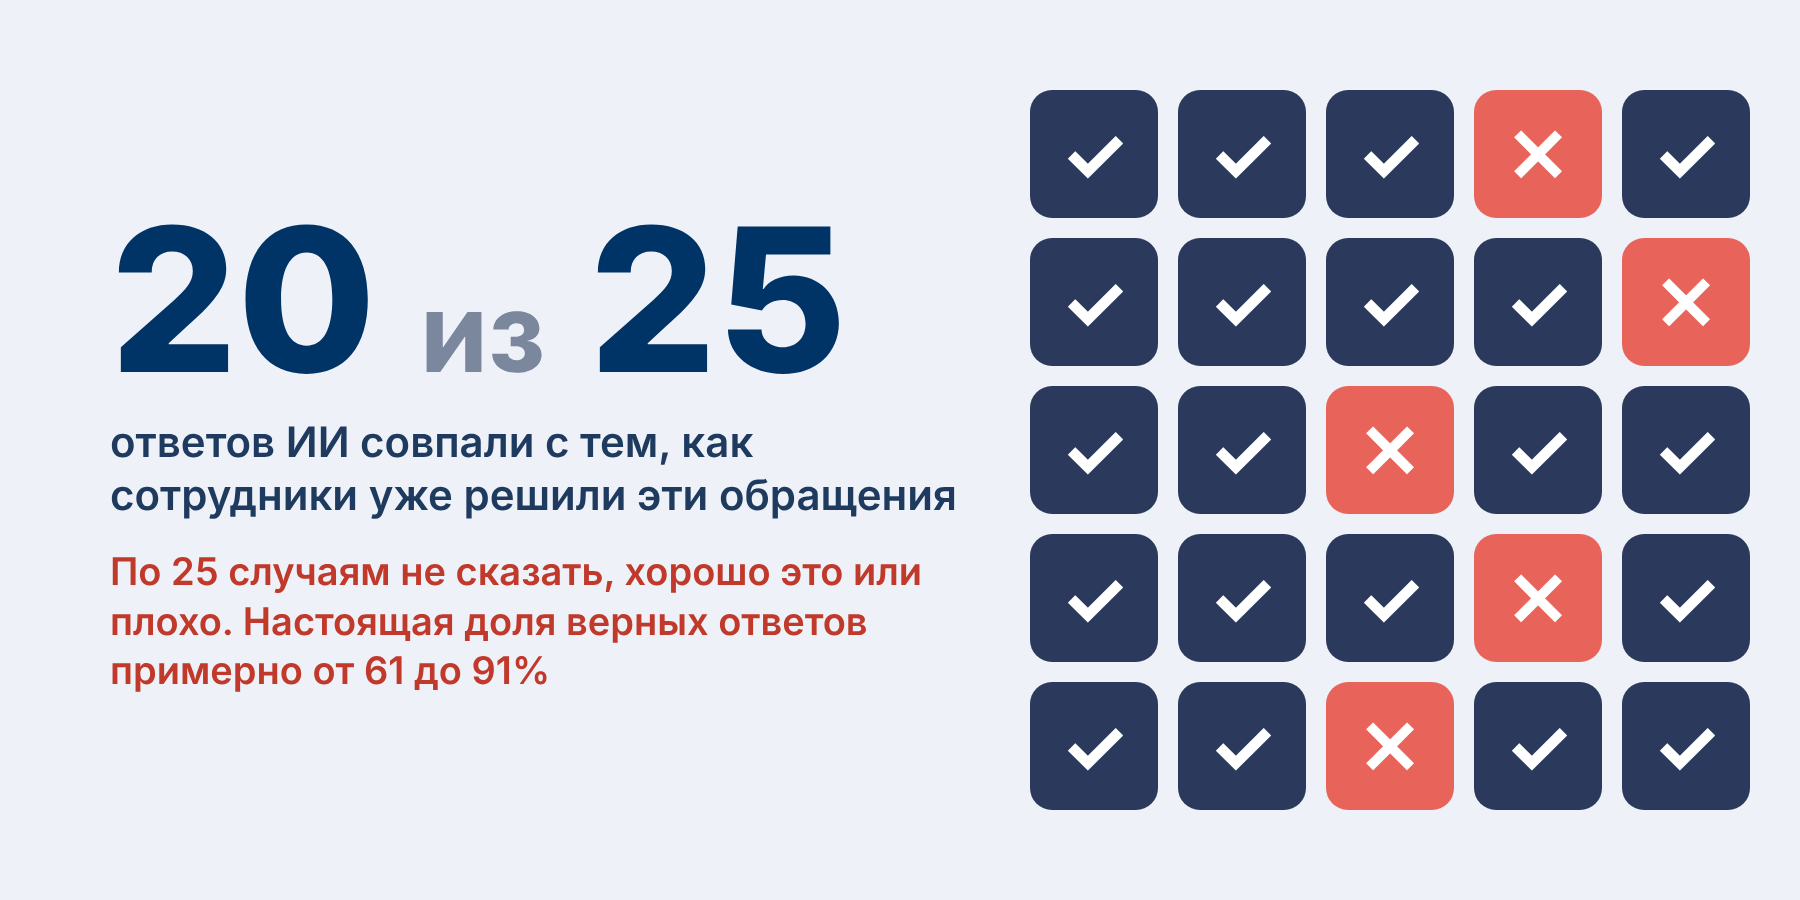
В конце октября 2026 года Сбер и аналитический центр TAdviser выпустили исследование «Генеративный ИИ в России: особенности, проблемы, тренды». Авторы опросили более 100 руководителей, которые отвечают за ИИ в российских компаниях, уже работающих с генеративным ИИ, и поговорили с ИТ-лидерами крупных компаний и с поставщиками технологий. В практических рекомендациях исследования есть прямой ответ на вопрос, какую задачу отдавать ИИ первой. Точку входа там советуют выбирать по четырём признакам:
- результат «обратим и носит характер черновика, а не окончательного решения»;
- «цена ошибки невысока»;
- «данные уже собраны в одном месте, машиночитаемы и не требуют долгой обработки»;
- «у процесса есть единственный владелец, а не несколько».
Исследование опубликовано на площадке Сбера СберПро, а Сбер сам продаёт LLM GigaChat, так что признаки отражают взгляд поставщика. Почти теми же словами их в интервью для исследования называет Дмитрий Филатов, эксперт фонда «Сколково», а в опросе признаки не проверяли.
В том же исследовании признано, что в ИИ-проекте результат «зависит от данных заказчика», и «Поставщики результат не гарантируют - и не могут гарантировать». Значит, проверять результат компании приходится самой, в том числе когда систему ставит подрядчик (интегратор, разработчик готового сервиса или поставщик LLM). С подрядчиками на первой задаче работают многие. По опросу, из компаний, которые пока пилотируют, преимущественно своими силами работают только 50%, и «к внешним командам чаще обращаются на входе».
При этом, по словам авторов, «С 2025 года финансовые директора требуют оценивать экономический эффект до начала проекта». До старта эффект можно только прикинуть, потому что он зависит от того, как часто ИИ ошибается на реальных случаях компании, а точно это покажет только пилот. Если результат пилота нечем посчитать, пилот не подтвердит эффект, которого ждёт финансовый директор, и решение о внедрении примут на впечатлении. В четырёх признаках есть обратимость и цена ошибки, а того, чем посчитать результат, нет. Само исследование пишет, что клиентский сервис «стал самым зрелым сценарием именно потому, что удовлетворяет всем четырём условиям сразу и вдобавок даёт готовую метрику эффекта» (долю обращений, закрытых без человека; при этом в опросе клиентский сервис назвали только 22% респондентов), то есть ставит эту метрику сверх четырёх признаков.
Поэтому я бы добавил пятый признак. Первой не стоит брать задачу, где тот, кто принимает результат ИИ (сотрудник, который его утверждает или берёт в работу, а для ответа бота сам клиент), ошибку в нём не видит и к началу пилота не будет ни правильных ответов, записанных людьми, ни назначенного специалиста со шкалой оценки, согласованной с подрядчиком. Например, срочную заявку, которую ИИ отнёс к обычным, никто не заметит, пока она ждёт в общей очереди, и если срочность не видна в истории обращений и её никто не отметит к началу пилота, такой пропуск на пилоте не посчитать. Если сегодня нет ни правильных ответов, ни специалиста со шкалой, вопрос в том, кто и к какому сроку это подготовит, и задача, к пилоту которой подготовят ответы или назначат специалиста со шкалой, пятый признак проходит. Третий признак исследования говорит о данных, с которыми работает ИИ, а пятый о правильных ответах, с которыми сравнивают его работу. Среди задач, которые проходят все пять признаков, первую я бы выбирал по расчёту экономики, который исследование советует делать «до старта и целиком».
В каких задачах, по исследованию Сбера и TAdviser, ИИ-проекты чаще доходят до постоянного использования и как там проверяют результат
Самым зрелым сценарием авторы считают клиентский сервис. По их словам, там «обращений много, они однотипны, результат каждого проверяем, а цена отдельной ошибки невысока и обратима - неудачный ответ можно исправить эскалацией на оператора». Эффект считают долей обращений, закрытых без человека, и она, как пишут авторы, «переводится в экономию напрямую».
Где цена ошибки высока, человек проверяет каждый ответ ИИ до отправки (так цифровой фармацевт Сбер Еаптеки на GigaChat отправляет ответы «только после верификации оператором-фармацевтом»), и, по словам авторов, такая схема «устойчиво воспроизводится всюду, где цена ошибки высока». Александр Вибе, директор Центра ИИ-решений для B2B Сбера, в интервью для исследования проводит границу доверия к ИИ-агенту «в классическом понимании» по трём осям (обратимость последствий, цена ошибки, проверяемость результата). Проверяемость результата у эксперта среди осей доверия есть, а в признаки точки входа она не попала, и пятый признак как раз о ней.
Как проверить результат ИИ в разных задачах и какую из них можно брать первой
Как проверять результат ИИ, решают два вопроса. Видит ли ошибку тот, кто принимает результат? Если не видит, можно ли заранее записать один правильный ответ? По ответам на них получаются три случая.
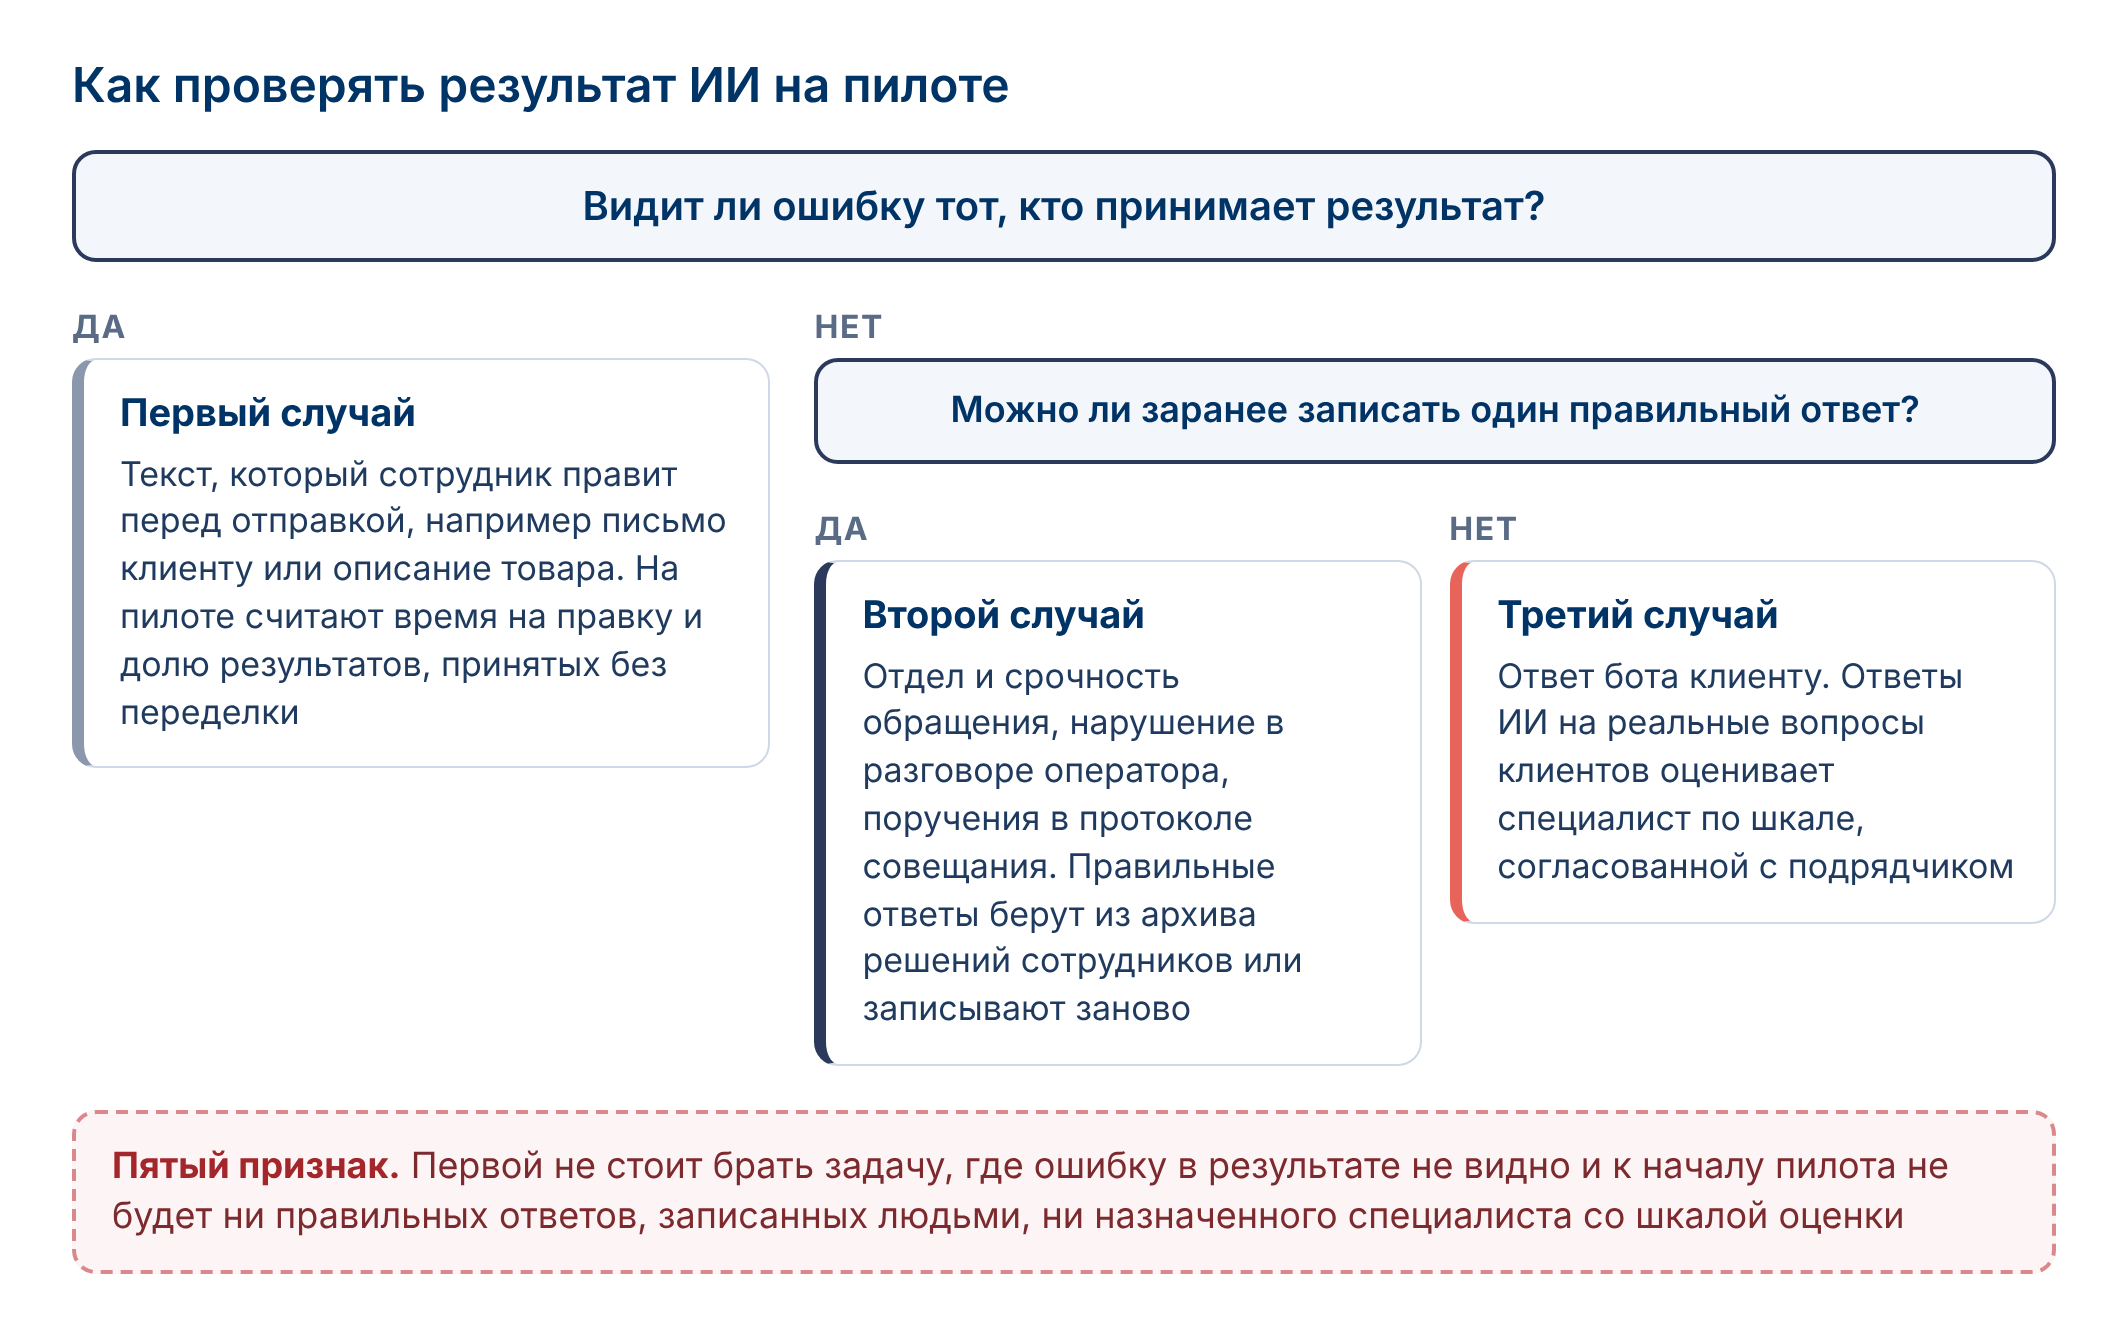
Первый случай касается задач, где ошибку видно в самом результате. Это текст, который сотрудник правит перед отправкой, например письмо клиенту или описание товара, и неудачную фразу в нём он заметит сам. Качество работы системы подрядчика здесь проявляется во времени на правку и в доле результатов, принятых без переделки, а посчитать их можно только на пилоте. Как это делать, мы писали в статьях об окупаемости внедрения ИИ (исходное состояние замеряют «на реальных заявках», сравнивают с контрольной группой) и о сравнении расходов на токены с зарплатой (по цене принятого результата решают, стоит ли отдавать задачу ИИ). Правильные ответы, записанные заранее, здесь не нужны, и пятый признак такая задача проходит.
Второй случай касается задач, где ошибку в результате не видно, но правильный ответ один и его можно записать заранее, например отдел и срочность обращения или нарушение в разговоре оператора. Сюда же попадает протокол совещания. Сотрудник его правит, но пропущенное поручение в аккуратном списке задач не видно. Зато список поручений проверяющий может составить по записи встречи до сверки с протоколом ИИ, и в статье об ИИ-протоколе совещания он «сначала составляет свой список принятых поручений по записи разговора». Правильные ответы для таких задач берут из архива решений, которые сотрудники уже приняли, или записывают заново, как проверяющий в статье о протоколе. Если архив есть или ответы успеют записать к началу пилота, пятый признак задача проходит.
Третий случай касается ответов, которые бот отправляет клиенту без проверки сотрудником. Результат принимает сам клиент. Бесполезный ответ он заметит и попросит оператора, а неверный по существу, например с неправильным сроком доставки, примет как есть. Доля обращений, закрытых без человека, то есть метрика из исследования, засчитает такой неверный ответ как закрытое обращение. Записать один правильный ответ заранее нельзя, у одного вопроса много хороших ответов. В статье о проверках после обновления ИИ-модели поставщика мы писали, что доля верных ответов подходит для задач с проверяемым ответом, а «для свободного текста нужен другой способ оценки». Здесь берут реальные вопросы клиентов, а ответы системы на них оценивает специалист по шкале, согласованной с подрядчиком. Такая оценка слабее сравнения с записанным ответом, потому что ответ ИИ подсказывает специалисту, что считать правильным. Пятый признак такая задача проходит, если к началу пилота специалист назначен и шкала согласована. Брать её первой я бы стал, только если неверный ответ обходится дёшево, а с бесполезным ответом клиент может уйти к оператору, как в клиентском сервисе из исследования, но это уже первые два признака исследования, обратимость и цена ошибки.
Что даёт архив решений сотрудников на короткой проверке подрядчиков и на пилоте
Архив решений сотрудников - это записи о решениях, которые люди уже приняли по этой задаче. Например, история обращений, где видно, в какой отдел специалист направил каждое обращение, или оценки, которые контролёры контакт-центра ставили разговорам операторов по каждому критерию. Часть такого архива можно не показывать подрядчику и сделать из неё проверочный набор. Система подрядчика решает случаи из набора, а её ответы сравнивают с решениями сотрудников.
Доля ошибок ИИ = случаи набора, где ответ системы не совпал с решением сотрудника / все случаи набора
Отдельно считают критичные случаи, где ошибка обходится дороже всего, например срочные заявки или грубые нарушения в разговоре, потому что в общей доле совпадений редкий случай теряется. Так считают в статье о классификации и маршрутизации обращений, где для срочных заявок видны «число обнаруженных и число пропущенных заявок».
Доля пропущенных критичных случаев = критичные случаи, которые система не распознала / все критичные случаи набора
Какую задачу брать первой, решают пять признаков и расчёт экономики, а архив решений сотрудников пригодится на двух этапах проверки подрядчиков. На короткой проверке перед пилотом по нескольким критичным случаям из набора можно дёшево отсеять подрядчиков с грубым провалом. На пилоте долю ошибок считают на сотнях случаев того же набора, и правильные ответы к ним не нужно составлять с нуля, так что подготовка к пилоту короче, чем без архива. Похожий порядок мы предлагали в статье о пилоте речевой аналитики, то есть ИИ-оценки разговоров операторов контакт-центра (короткая проверка двух-трёх подрядчиков на двух-трёх критических критериях, затем пилот по всем критериям у одного-двух финалистов, оба этапа до договора на внедрение).
Чем проверка подрядчика на архиве решений сотрудников отличается от оценки его прототипа ключевым пользователем
Компания ClaudeLab, которая внедряет ИИ для бизнеса, в статье о плане внедрения (сентябрь 2026 года) предлагает до договора на полную разработку собрать прототип на данных клиента, пропустить через него 20-50 свежих случаев из работы и дать ключевому пользователю (сотруднику отдела, где пройдёт пилот, который каждый день делает эту работу) оценить каждый ответ по шкале «можно отправлять как есть, нужна правка, неверно». Для ответов бота клиенту (третий случай) проверка устроена почти так же. Во втором случае на том же этапе, до пилота, у проверки на архиве есть два отличия:
- Правильный ответ записан до того, как кто-то увидел ответ ИИ, потому что его уже принял сотрудник, и ответ ИИ не подсказывает проверяющему, что считать правильным.
- Набор один для всех подрядчиков, и, по моей оценке, подогнать систему под набор, которого подрядчик не видел, не удастся.
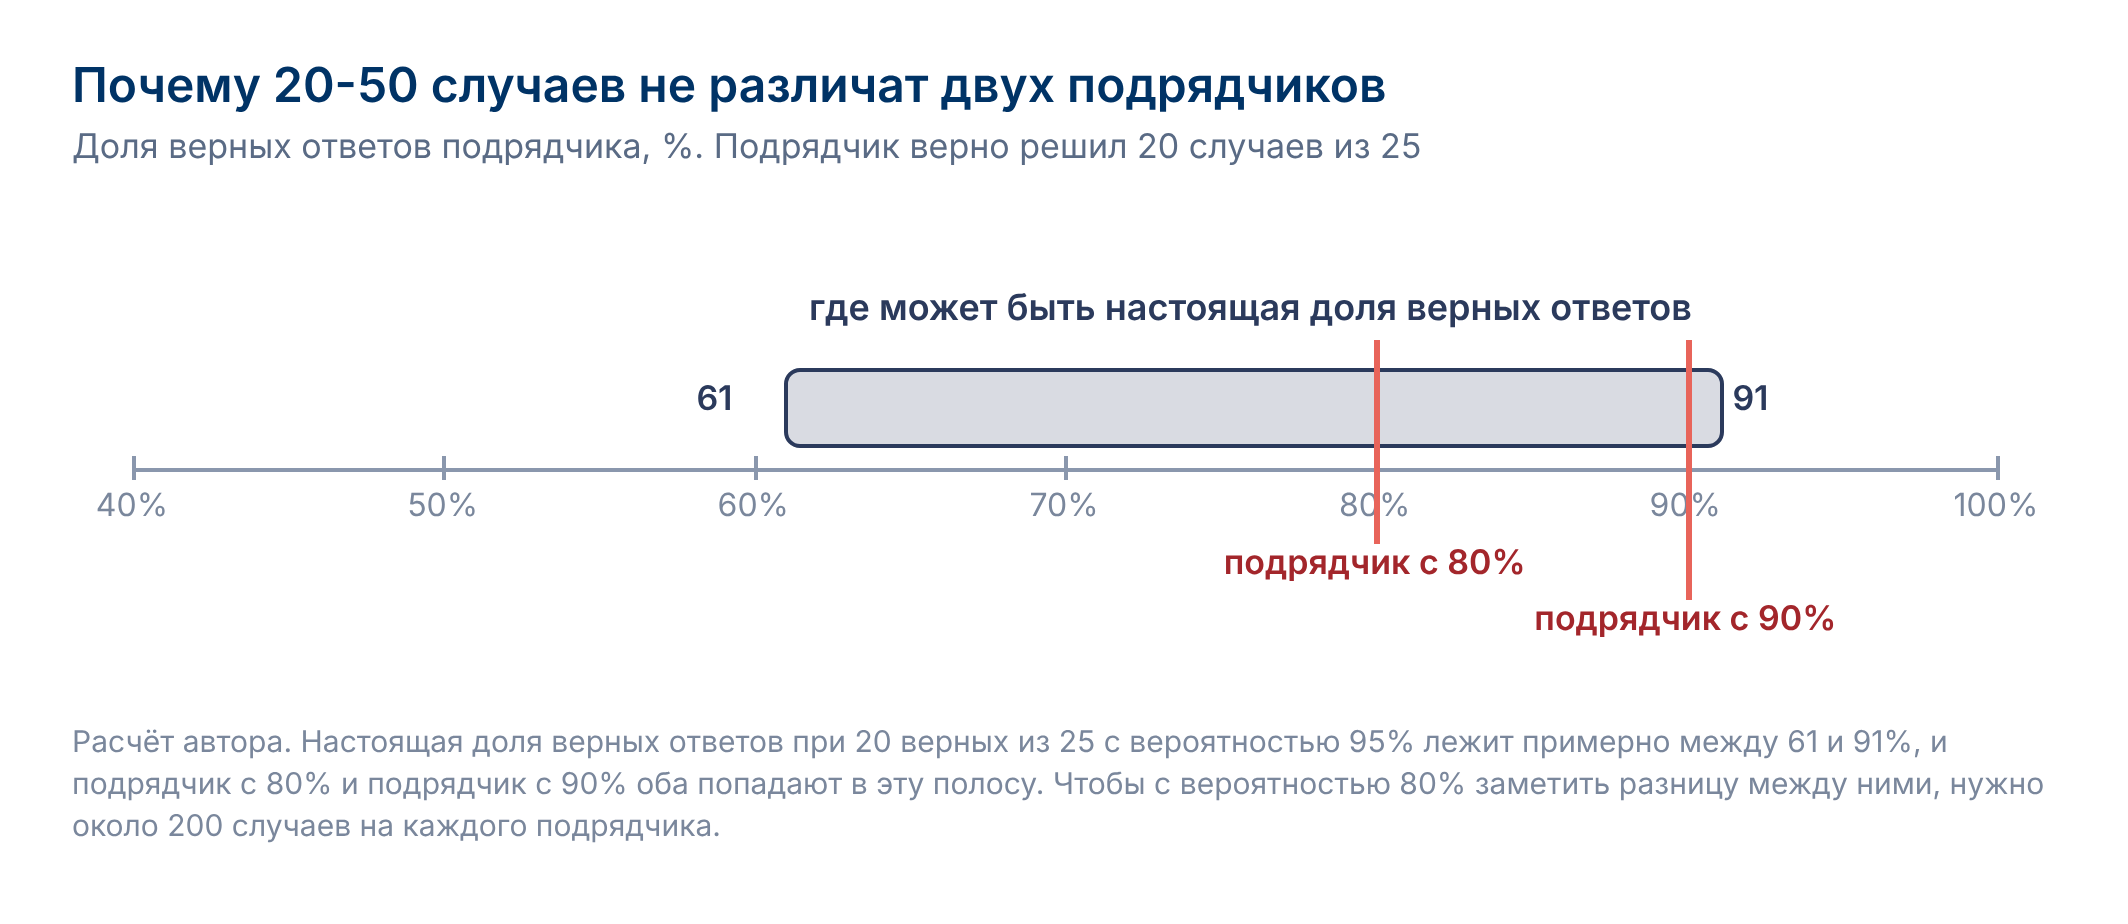
На пилоте случаев нужно больше, чем у прототипа. Если подрядчик верно решил 20 случаев из 25, настоящая доля верных ответов, по моему расчёту, с вероятностью 95% лежит примерно между 61 и 91%, то есть 20-50 случаев покажут грубый провал, но двух подрядчиков не различат. Чтобы на пилоте с вероятностью 80% заметить разницу между подрядчиком с 80% верных ответов и подрядчиком с 90%, нужно, тоже по моему расчёту, около 200 случаев на каждого подрядчика (если подрядчики ошибаются на одних и тех же случаях, на общем наборе хватит и меньшего). Записать 200 правильных ответов с нуля - это отдельная работа, а в архиве они уже лежат. Публичного российского случая, где заказчик сравнил бы подрядчиков на своём архиве и опубликовал числа, найти не удалось, так что это моё суждение.
Как проверить, годится ли архив решений сотрудников для проверки подрядчика ИИ
До того как делать из архива проверочный набор, стоит ответить на четыре вопроса.
- Принимались ли решения по тем правилам, по которым будет работать ИИ? В сервисной сети по ремонту бытовой техники Ленремонт ИИ-оценку разговоров операторов по чек-листу внедряла компания Aiston. По статье исполнителя на Хабре (ноябрь 2025 года), при подготовке отобрали по 10 разговоров каждого типа и выяснили, что контролёры оценивали разговоры не по всему списку. По словам исполнителя, «изначальный список критериев был скорее теоретическим. Реально в оценке использовались лишь 3-4». Если правило недавно поменялось, старые решения по нему не годятся, и вопросы по новому правилу составляют отдельно, как в статье об обновлении базы знаний ИИ-ассистента.
- Записано ли в архиве само решение сотрудника? В журнале поиска интернет-магазина лежит история того, что люди вводили в строку поиска, а какой товар был правильным, в нём не записано. Поэтому в статье об умном поиске для интернет-магазина правильные товары отмечает сотрудник, который знает ассортимент, например категорийный менеджер.
- Совпадают ли решения разных сотрудников на одних и тех же случаях? Об оценках контролёров в статье о пилоте речевой аналитики сказано, что «Начать можно с оценок прошлых месяцев, но их точность тоже неизвестна», и одни и те же разговоры там советуют дать двум контролёрам.
- Хватает ли в архиве критичных случаев? По расчёту в той же статье, при 50 нарушениях долю найденных системой нарушений (если она находит около 70%) удаётся оценить с погрешностью около 13 процентных пунктов, а при нарушении в 2% разговоров 50 таких случаев с вероятностью около 92% наберутся среди 3 000 размеченных разговоров. Поэтому к набору добавляют известные нарушения из жалоб и прошлых проверок, помня, что они могут быть заметнее средних и доля найденных на них может оказаться выше, чем на всех разговорах.
Где брали правильные ответы для проверки ИИ в задачах из наших статей
| Задача | Что считается правильным ответом | Откуда его берут | Когда проверяют |
|---|---|---|---|
| Оценка разговоров операторов контакт-центра | оценка контролёра по каждому критерию | оценки контролёров прошлых месяцев, перепроверенные двумя контролёрами | короткая проверка на двух-трёх критических критериях, затем пилот по всем критериям, оба до договора на внедрение |
| Классификация и маршрутизация обращений | отдел, который должен получить обращение, и срочность | обращения из работы, правильное назначение подтверждает специалист | до покупки |
| Умный поиск интернет-магазина | товар или список товаров, подходящих запросу | запросы из журнала поиска, правильные товары отмечает сотрудник, который знает ассортимент | на пилоте, до договора с поставщиком поиска |
| Выбор LLM для своей системы | ответ, который компания считает правильным | реальные задания системы, ответы к ним записывают | до выбора поставщика LLM |
| Контрольный набор после обновления ИИ-модели поставщика | ответ, который уже известен по реальному обращению или документу | обращения и документы банка с уже известным ответом | после запуска, по расписанию и при каждой смене версии |
| ИИ-агент в 1С и CRM | записи, которые агент должен создать по письму клиента | составляют заранее вместе с подрядчиком | до покупки, сбои при приёмке |
| ИИ-протокол совещания | список поручений, который проверяющий сам составил по записи встречи | составляют под проверку | при испытании сервиса на встречах своей команды |
| Обновление базы знаний ИИ-ассистента | ожидаемый ответ и подходящий источник для вопроса по изменённому правилу | составляют под проверку | после запуска, при каждом обновлении |
Готовые правильные ответы из работы компании наши статьи брали дважды (оценки контролёров прошлых месяцев, обращения и документы банка с известным ответом), в остальных случаях ответы подтверждал специалист или их составляли заново. Если готовых ответов нет, их запись - это работа, которую стоит заложить в срок и бюджет.
Какие возражения против проверки подрядчика на архиве решений сотрудников и что на них ответить
Первое возражение в том, что проще записать результат в договор. Андрей Дмитриев из Сбера в интервью для исследования рассказывает о сценариях, которые сам называет экстремальными, когда «крупные холдинги даже внутри договора на разработку за вендором, за интегратором фиксируют ответственность и влияние на производственные KPI, которые сами же считают». Производственный показатель зависит от многого помимо подрядчика, и спор о нём, по моей оценке, сложнее спора о доле ошибок на наборе, который лежит у компании и которого подрядчик не видел.
Второе возражение в том, что подрядчик не станет проверять свою систему бесплатно. По моей оценке, короткая проверка на нескольких критичных случаях стоит ему немного, а пилот на всём наборе обычно оплачивает заказчик.
Какие вопросы задать на совещании о первой задаче для ИИ и на встрече с подрядчиком
На совещании о первой задаче по каждой задаче-кандидату стоит задать пять вопросов:
- Проходит ли задача четыре признака исследования и окупается ли она по расчёту экономики?
- Видит ли тот, кто принимает результат ИИ, ошибку в самом результате (неудачную фразу видно, пропущенное поручение или срочную заявку в общей очереди нет)?
- Если не видит, можно ли заранее записать один правильный ответ (отдел, оценка, список поручений), есть ли архив таких решений по тем же правилам, совпадают ли решения разных сотрудников и сколько в архиве критичных случаев?
- Если один правильный ответ записать нельзя, кто из специалистов будет оценивать ответы ИИ на пилоте и по какой шкале, согласованной с подрядчиком?
- Если ошибку в результате не видно и ни правильных ответов, ни специалиста со шкалой сегодня нет, кто и к какому сроку подготовит их к началу пилота? Без такого плана задача не проходит пятый признак, и первой её лучше не брать.
На встрече с подрядчиком по выбранной задаче полезно задать пять вопросов:
- Согласен ли подрядчик на короткую проверку до пилота, то есть отдать ответы своей системы на несколько критичных случаев из набора, который он не видел, чтобы компания сама посчитала совпадения с решениями сотрудников и пропущенные критичные случаи?
- На каком наборе и против чьих ответов получен процент точности из его презентации?
- Готов ли он на пилоте отдавать ответы системы на том же наборе, чтобы долю ошибок посчитала компания?
- Если результат правит сотрудник, как на пилоте будут замерены время на правку и доля принятых результатов?
- Если ответы уходят клиенту без сотрудника, кто и по какой шкале оценит их на реальных вопросах клиентов?
Архив обращений и разговоров почти всегда содержит персональные данные, и поручить их обработку подрядчику 152-ФЗ (ч. 3 ст. 6) позволяет с согласия людей, чьи это данные, если иное не предусмотрено федеральным законом, и по договору с подрядчиком, причём если система работает на его серверах, такой договор, как сказано в статье о пилоте речевой аналитики, нужен уже на время короткой проверки и пилота. Проще всего проверять систему на серверах самой компании (о LLM на своих серверах мы писали в статье о 152-ФЗ), а как оформить передачу данных, решает юрист.
Начать я рекомендую до первой встречи с подрядчиками, со списка задач-кандидатов и с двух вопросов к каждой. Видна ли ошибка ИИ тому, кто принимает результат? Если не видна, будут ли к началу пилота правильные ответы, записанные людьми, или назначенный специалист со шкалой оценки, согласованной с подрядчиком, и кто это подготовит? Задачи, где к пилоту не будет ни того, ни другого, первой брать не стоит. Среди остальных первую я бы выбирал по четырём признакам исследования и расчёту экономики.
