«Обновления, которые вендор выпускал для других клиентов, могли влиять на наше качество». Эту строчку опубликовал крупный российский интегратор в разборе собственного ИИ-ассистента по внутренним документам.
Это разбор КРОКа на Хабре, март 2026 года. Ассистент по регламентам, методичкам, договорам и проектной документации, целиком внутри закрытого контура. Ядро системы они купили готовым у внешнего поставщика. В списке того, что далось им с этой платформой тяжелее всего, первым пунктом стоят его апдейты, менявшие качество, и метрика при них 85 процентов и 70. Что именно считают этими процентами, статья не поясняет.
Задача, с которой они начинали, знакома всем, у кого документов много. Поиск по внутренним документам формально работает, но нужное находится не сразу, и сотрудники нередко тратят часы, вспоминая формулировку документа, его место и контекст. Заметнее всего это для новых сотрудников и для любого, кто полез в документы, с которыми раньше не работал.
Сложнее техники, по их же словам, оказались процессы с поставщиком. Выстраивать пришлось, дословно, «регулярные статусы; прозрачность поставок; понятную схему согласования изменений».
Качество ответов они при этом меряют на собственных данных. Формируют эталонные документы и вопросы, прогоняют по ним систему и измеряют метрику. Фактический ответ сличается с ожидаемым по заданным критериям, сначала это делали руками, потом отдали отдельной модели, а случаи из живой работы пополняют библиотеку тестов. Свои наборы документов и типовых вопросов они готовили ещё на этапе выбора поставщика и по ним мерили качество ответов у кандидатов.
Дальше моё, в статье этого нет. Выглядит эталонный набор буднично. Профильный эксперт заказчика сам пишет список вопросов и правильные ответы к ним. Этот список и есть эталон, с которым дальше сверяют машину. У нас таких расчётов по пилотам одиннадцать, и в десяти из них этап, где заказчик собирает эталон и прогоняет по нему проверку, оказывается самым дорогим по его времени, от 32 до 82 часов его собственных специалистов.
У КРОКа история кончилась хорошо, система дошла до рабочего состояния. Но дошла она через почти год совместной работы с поставщиком. Мне кажется, граница между теми, у кого ИИ работает, и теми, у кого он однажды перестал, проходит именно здесь, по наличию своего эталона. Мы этот этап ставим в план пилота отдельной строкой, потому что без него о качестве ответов приходится верить подрядчику на слово.
❤2👍2
БизнесМатика
Рейтинг LLM-платформ для внедрения в контуре компании. Семь российских платформ 2026 года
Сравнение 7 российских LLM-платформ для установки в инфраструктуре заказчика, включая закрытый контур. Критерии сравнения включают сменяемость LLM, маскирование персональных данных и журнал действий.
Мы выпустили рейтинг LLM-платформ, в котором наша ИИ-платформа Svaya заняла первое место.
Это рейтинг про отдельную категорию софта. Банкам, страховым и промышленным компаниям часто нельзя выпускать перс. данные клиентов и внутренние документы за периметр своей сети, а прикладные задачи для LLM у них во многом те же, что у остальных. Под это ограничение сложились платформы, которые ставятся в инфраструктуре заказчика, включая закрытый контур без доступа в интернет. Мы сравнили 7 российских платформ по шести критериям - платформ, которые заявляют такую поставку или, как минимум, хранение данных внутри периметра заказчика. По нашему опыту, эти 6 пунктов заказчики выясняют у вендора первыми: от работы в контуре и поиска по документам компании до того, получает ли заказчик исходный код.
В тексте рейтинга объяснили, почему в рейтинге нет самих GigaChat и YandexGPT, хотя платформа GigaChat Enterprise в нём есть. LLM отвечает на запрос. Платформа отвечает за то, что происходит вокруг него. Кто имеет право его задать и по каким документам. Что замаскировать до отправки текста в LLM. Что записать в журнал для службы безопасности. Как заменить LLM, когда выйдет лучшая версия.
В конце статьи собраны пять вопросов заказчика к вендору перед выбором ИИ-платформы (любому, включая нас самих). Например, что нужно для старта (покупка программно-аппаратного комплекса или установка на имеющиеся серверы) или сколько инженеров (вендора или своих) потребует сопровождение.
Полный текст рейтинга тут.
👍3❤2
БизнесМатика
Платформа для внедрения языковых моделей - это не обертка над GigaChat. Как устроена наша Svaya, от маскирования персональных данных…
БизнесМатика - это ИТ-компания, которая работает с 2012 года. Мы занимаемся заказной разработкой ПО и внедряем проекты на базе языковых моделей (LLM) для…
В России подписан закон об ИИ, 243-ФЗ, с 1 сентября он вступает в силу. Сам закон про большие фундаментальные ИИ-модели, включая LLM, и про господдержку их развития. Выглядит темой для разработчиков, а на деле задевает и обычные внедрения, где языковая модель встроена в рабочий процесс.
Закон описывает большие фундаментальные модели, от миллиарда параметров, и вводит для них две категории. Суверенная модель разработана российским юрлицом, контролируется им на всех стадиях жизненного цикла и живёт в российских дата-центрах. Национальную тоже разрабатывает российское юрлицо, но она может использовать зарубежные компоненты с открытой лицензией. Обе категории дают господдержку и доступ к государственным данным для обучения. Ещё одна норма отдаёт государству право требовать только российские модели в отдельных госсистемах и других чувствительных сферах.
Для внедрений это меняет порядок вопросов. Модель привыкли выбирать по тому, как она справляется с конкретной задачей. Теперь рядом с бенчмарком встаёт регуляторный статус. Какая модель лучшая, решает замер. Какая допустимая, решает регулятор, причём перечень чувствительных сфер закон оставляет за государством, и ответ может измениться после того, как ваш проект уже запущен.
Кроме этого, закон обязывает крупные площадки дать пользователям возможность помечать созданные нейросетями аудио- и визуальные материалы, а разработчикам разрешает обучать модели на правомерно доступных объектах авторского права. Детали в новости на Хабре.
Практический вывод архитектурный. Внедрение не должно прирастать к конкретной модели. Такая жёсткая связка превращает любой поворот регулятора в переписывание прикладной части, по цене нового проекта. Мы поэтому заложили сменяемость LLM в архитектуру своей ИИ-платформы Svaya. GigaChat, YandexGPT и открытые модели меняются в ней как компонент, прикладная часть остаётся на месте. Как это устроено, описано на сайте. Спросите свою команду, во что обойдётся замена модели в том, что у вас уже работает, и лучше до 1 сентября.
❤2👍2
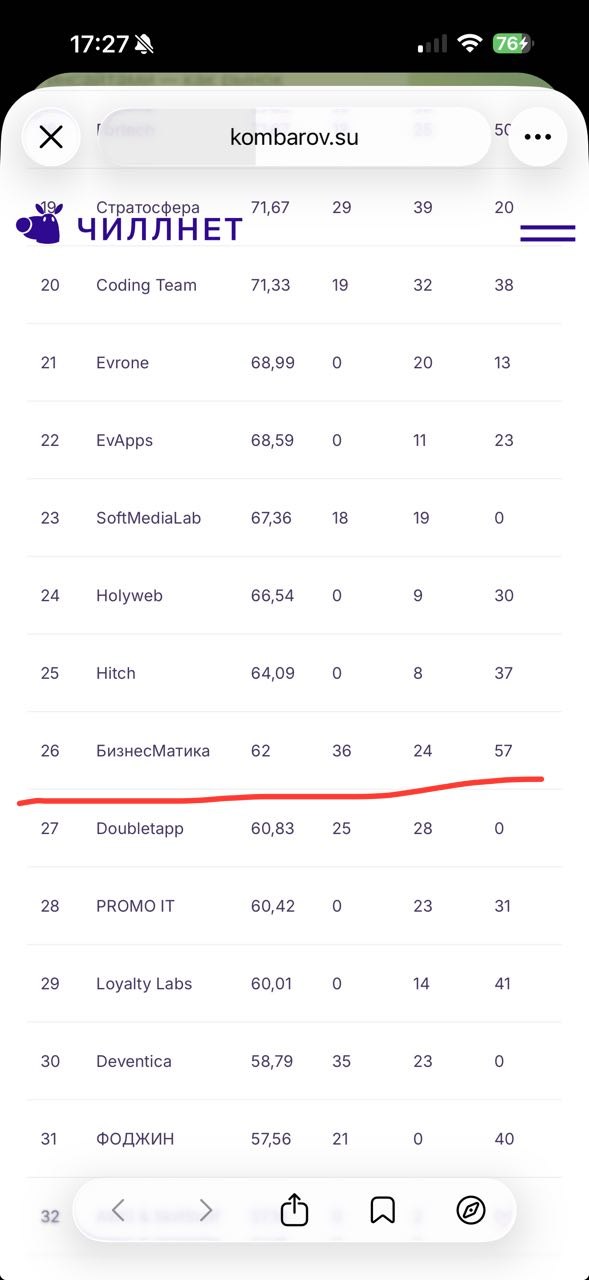
Вышел Рейтинг Чиллнета 2026. БизнесМатика в нём на 26-м месте из ста в разделе аутстаффа и на 64-м из ста в разделе мобильной разработки. Разница между этими двумя строчками объясняется механикой рейтинга, и её стоит разобрать.
Чиллнет устроен непривычно. Он не собирает заявки и анкеты. Автор берёт четыре давно живущих рейтинга подрядчиков, Рейтинг Рунета, Workspace, Tagline и Digirate, и складывает места компаний в них. Правило сформулировано прямо. «Чем в большем количестве рейтингов компания участвует и чем выше ее места в них, тем больше баллов». Разделов пять, по сотне компаний в каждом. Сайты, мобильные приложения, аутстафф, дизайн, seo.
Отсюда следует, что балл здесь измеряет присутствие компании в чужих рейтингах. Наши две строчки это показывают. Раздел аутстаффа собран из трёх источников, и мы есть во всех трёх, правда не в верхах, на 36-м, 24-м и 57-м местах. В сумме 62 балла и 26-я строка. Раздел мобильной разработки собран из четырёх источников, и мы попали ровно в один. В сумме 41 балл и 64-я строка. О том, как мы делаем мобильные проекты, эта разница не говорит ничего.
Тому, кто выбирает подрядчика, отсюда следует простое. Агрегатор годится как список кандидатов. Оценкой работы он быть не может по устройству. Компания, которая не подавалась ни в один рейтинг, получит ноль, как бы она ни вела проекты. Смотреть надо методику первоисточника. Что там вообще ранжируется, отзывы, выручка, кейсы или аккуратно заполненная анкета.
Поэтому свои 26-е и 64-е места мы называем как есть, вместе с механикой, по которой они получились. Если рейтинг попадётся вам при выборе подрядчика, откройте его методику и спросите самого подрядчика, за что он получил своё место. Сам Рейтинг Чиллнета тут.
❤1🔥1
БизнесМатика
БизнесМатика — Заказная разработка, искусственный интеллект и усиление команд
Системный интегратор: ИИ-трансформация, ИТ-аутстаффинг, заказная разработка для среднего и крупного бизнеса.
Подрядчик, который считает вам смету, редко говорит, что проект вам не нужен. Сегодня мы выложили на сайт числа, ниже которых сами не берёмся за ИИ-проект.
Их десять, по одному на задачу нашей ИИ-платформы Svaya. Каталог примерно от 15 150 позиций для карточек товаров. От 750 часов аудитора в месяц для разбора финансовой отчётности. От 10 человек, занятых вычиткой документов полный день. И так по каждой строке, с ролями и оговорками.
Там же честно написано, чего эти числа стоят. Ни один расчёт ещё не проверен живым проектом. Четыре порога из 10 мы пересчитали 8 августа, потому что старые не сходились с нашим же калькулятором. А одиннадцатую задачу посчитали и пока не продаём. Внутри открыт спор, у кого в ней на самом деле высвобождается время, и мобильное рабочее место для неё пока не построено.
Зачем это читать вам. Найдёте свою строку и до всякой встречи с нами поймёте, проходит ли ваш масштаб. Если не проходит, вы узнали это заранее и бесплатно. Задача остаётся задачей, просто под неё не нужен такой проект. А если ИИ вам предлагает другой подрядчик, в конце есть четыре вопроса ему. Ниже какого объёма вы за эту задачу не берётесь?
Лонгрид целиком лежит по ссылке, читается минут за семь.
🔥2❤1
Компания, у которой больше ста собственных проектов на генеративном ИИ, публично объяснила, почему один только запрет нейросетей для сотрудников ничего не решает.
Вот как это формулирует «АльфаСтрахование» в свежем августовском пресс-релизе в Ведомостях. «Формальный запрет на использование нейросетей не означает, что сотрудники откажутся от них в работе. Не получив безопасного внутреннего инструмента, они могут загружать договоры, персональные сведения и другую служебную информацию в общедоступные сервисы».
Так говорит страховщик, который сам ведёт больше 100 GenAI-проектов, по его же майской новости на CNews. Внутренний помощник «НейроМаша» уже работает примерно у 10 тысяч страховых агентов компании. Помогает со сложными страховыми продуктами, оценивает клиентскую ситуацию, говорит, попадает ли случай под перечень рисков и какие документы нужны для оформления.
Пока в компаниях обсуждают, «внедрять ли ИИ», сотрудники уже внедрили его себе сами, в первый попавшийся бесплатный чат-бот. Этот вопрос закрыт, и закрыли его не на совете директоров. Открытым остаётся вопрос, что уходит наружу вместе с запросами, которые ваши люди набирают в чужой модели. У страхового агента в руках договоры, паспорта, справки, и удобный внешний сервис не спрашивает, можно ли ему всё это показывать.
Пара этих новостей складывается в одну картину. Спрос сотрудников на нейросети компания признала фактом, с которым бесполезно воевать одним запретом, и дала агентам своё место для рабочих вопросов. Внутренний помощник заточен под продукты самой компании, под то, что агент иначе понёс бы в чужое окно.
Если у вас запрет уже написан, а внутреннего инструмента нет, то пауза во внедрении ИИ вам только кажется. На деле у вас внедрение, которым никто не управляет. Я бы на ближайшей планёрке задал два вопроса. Куда сейчас уходят наши документы? И что мы дадим людям взамен?
Мы в БизнесМатике как раз строим такие инструменты, собираем защищённый контур с языковой моделью внутри периметра, маскируем персональные данные, разграничиваем доступ по ролям. Запретами не занимаемся, ими рынок и так обеспечен 😎
❤2
БизнесМатика
Транспортная накладная становится электронной. Подготовиться к 1 сентября в одиночку нельзя
За пять дней до перехода на электронные накладные проще всего успокоиться. В июне 2026 года на совещании у Президента глава Минтранса предложил до 1 марта 2027…
Перевозчикам пообещали отсрочку штрафов за бумажные накладные. Мы пошли смотреть, какие именно штрафы откладывают, и не нашли ни одного, адресованного компании.
В июне на совещании у Президента глава Минтранса предложил до 1 марта 2027 года ограничиваться устным предупреждением, если инспектор при остановке машины получит бумажный документ вместо электронного. Поручение по итогам того совещания опубликовано 19 июля, и круг адресатов в нём шире. Устное замечание обещано участникам перевозочного процесса, а это уже и компании. По федеральным лентам поручение разошлось как отсрочка штрафов.
Ближайшее к такому штрафу в КоАП это часть 2 статьи 12.3, и она про водителя, у которого нет при себе положенных документов, включая товарно-транспортные. Наказание по ней это «предупреждение или наложение административного штрафа в размере пятисот рублей». А решения, которые МВД и Ространснадзор должны принять по июльскому поручению, к концу августа не опубликованы. Принять их велено к 1 сентября.
Зато 1 сентября меняется сама статья 8 Устава автомобильного транспорта. Сегодня она разрешает выбирать форму документа, а с сентября общим правилом становится электронная. «Транспортная накладная формируется в виде электронной транспортной накладной», говорит новая редакция. Восемь случаев, где бумага законна и после этой даты, перечислены приказом Минтранса № 262.
Вот где настоящая цена перехода на электронные накладные. Электронная накладная по формату ФНС включает четыре обязательных файла обмена, и подписывают их три стороны перевозки (грузоотправитель, перевозчик и грузополучатель). Пока хоть одна из них остаётся на бумаге, электронной накладной по вашей перевозке не будет и у вас, как бы рано вы сами ни подключились к оператору информационной системы электронных перевозочных документов.
Одного вашего подключения к оператору мало. За дни, что остались до 1 сентября, имеет смысл обзвонить тех, с кем вы возите, это ваши грузоотправители, грузополучатели и перевозчики, если возите не сами, и задать каждому два вопроса, с каким из таких операторов он работает и на какую дату намечено подключение. Кто не ответит внятно, тот и есть ваша сентябрьская бумага, а её объём меряется в перевозках в неделю, и посчитать его можно прямо сейчас.
В статье эти 8 случаев перечислены с оговорками, которые спрятаны внутри формулировок приказа. Там же разобрано, что приказ выписан до 1 сентября 2032 года, и почему такой срок ничего вам не обещает. Там же свежая деталь про готовность самого государства. Один документ успели дооформить буквально на днях, за двенадцать дней до 1 сентября. Бумагу от неготовых контрагентов разберёт наша ИИ-платформа Svaya. Обзвон, с которого всё начинается, она за вас не сделает.
Лонгрид целиком лежит по ссылке, читается минут за семь.
❤2
LeaderChat ставит онлайн-чаты на сайты компаний, клиенты пишут туда про цену, оплату, доставку. В августе о сервисе вышла статья на Хабре по мотивам интервью с CEO Дмитрием Бусовым. «Около 90% обращений состояли из одних и тех же вопросов».
Типовые вопросы там передали языковой модели, сложные диалоги оставили операторам. Стоимость обработки одного лида упала примерно в десять раз против работы живых операторов, качество обработки обращений осталось прежним. Этой экономикой, по статье, заказчиков и убеждали принять переход.
Обработка обращений заказчику действительно обходится значительно дешевле, чем работа живых операторов. Статья говорит это прямо, и я не спорю.
Операторы при этом остались. Сотрудники «перестали тратить время на однотипные консультации и сосредоточились на действительно сложных обращениях», а отдельным пунктом в выводах стоит «Не пытаться заменить человека полностью». Одна фраза статьи читается наоборот. Про отдельный сервис работы с языковыми моделями там сказано, что он «просто заменил прежнее рабочее место оператора». Читаю это как фразу про устройство продукта. Штата она не касается. А расходы на операторов статья с самого начала числит расходами компаний. Бизнесу, по её словам, «содержать полноценную команду операторов дорого». Чего она не говорит, так это какую долю обращений забрала языковая модель.
И вот из-за чего я взялся за этот кейс. Десятикратное удешевление посчитано в расчёте на лид. Стоимость обработки лида и расходы на людей - это разные величины, и падение первой само по себе ничего не говорит о второй.
Строка расходов на людей движется ступенями. Про небольшие компании в статье сказано, что «каждый новый сотрудник - это постоянные расходы на найм, обучение и контроль». Вверх это работает по словам самой статьи. Наняли человека, и расходы на людей выросли скачком. Что вниз то же самое не срабатывает - это уже моё рассуждение. Пока высвобожденные у операторов часы не сложатся в целую ставку, расходы на операторов не изменятся ни на рубль.
Проверьте на своих числах. Долю типовых обращений вы прочитаете по своим диалогам. В LeaderChat 90% нашли именно так. Умножьте годовое число обращений на эту долю, потом на ту её часть, которую заберёт языковая модель, и на время разбора оператором одного типового обращения в часах. Полученные часы поделите на годовой фонд рабочего времени оператора. Вышло 2,5 ставки - убрать можно две, и то если график смен позволит. Вышло 0,8 ставки - нельзя ни одной. Формула считает в мою пользу, и я это признаю. Годовой фонд в знаменателе, график смен только вычитает, высвобождение беру лишь на типовых. Читайте её результат как нижнюю границу.
А рядом в бюджете появляется новая строка, и она не про людей. Заказчик покупает тариф. Что поштучный счёт остаётся на стороне LeaderChat, а к заказчику приходит ступенькой тарифа, я вывожу сам. Как тариф соотносится с убранной ставкой, статья не говорит.
Поэтому в расчёте автоматизации меня занимает другой вопрос. Что произойдёт с расходами на операторов? Ответов несколько, и экономию они дают разную. Кто-то из операторов уйдёт. Кто-то из них перейдёт на продажи, и деньги придут выручкой. Либо расходы на операторов останутся прежними, и тогда выигрыш у вас есть, но лежит он во времени на сложных обращениях.
Одно возражение против себя произнесу сам. Граница простого и сложного уже сдвинулась. В статье сказано, что теперь «можно автоматизировать не только ответы на типовые вопросы, но и полноценные консультации». Если граница сдвинется и дальше, часы, не сложившиеся в ставку сегодня, сложатся позже. Расчёт от этого не отменяется, он делается заново.
Целую ставку убирают решением руководителя. Дробная так не убирается. Иногда она превращается в деньги другой дорогой - через найм, которого не потребуется при росте числа обращений. Оговорюсь сразу, ненанятый человек - это такое же условное допущение, как и кратность, которую я тут разбираю. А иногда дробная часть не превращается ни во что, и это тоже результат расчёта. Знать его лучше заранее.
Мы такой расчёт приносим до пилота, на обращениях и ставках заказчика 🙂
❤2
БизнесМатика
Что можно узнать об ИИ-платформе до первой встречи с вендором
В двадцатых числах августа мы сели разбирать чужую корпоративную ИИ-платформу по её открытым материалам (сайт, каталог коннекторов, документация). Первое…
В конце августа мы сели изучать корпоративную ИИ-платформу Landev AI группы компаний ЛАНИТ по её сайту и документации. Первое расхождение между обещанием вендора и его продуктом нашли у себя.
Пункт 4.1 публичной оферты нашей же ИИ-платформы Svaya обещал, что результаты запусков автоматически удаляются через 30 суток. Код этого не делал. Исправили в тот же день, а из способа проверки вырос текст.
Сегодня разбор этой платформы вышел на сайте. На одной странице вендора число названо трижды, и числа не сходятся. В служебном описании стоит «50+» коннекторов, в шапке «более чем 100 приложениям», в тексте ниже «Более 100 готовых коннекторов». А в каталоге на той же странице перечислена 21 позиция, и список обрывается на букве D. Это не доказывает, что коннекторов меньше сотни, каталог может быть просто недописан. А проверить это число по открытым материалам покупатель не может, и вот с таким фактом он приходит на первую встречу с вендором.
Внутри процедура из трёх шагов. Она делит вопросы на те, что закрываются чтением сайта и документации вендора, и те, что закрываются только договором, сколько ни читай. И показывает, как за час-полтора сверить маркетинговую страницу с артефактом, который обязан быть точным. Работает без нас, покупать ничего не нужно.
Свою платформу Svaya мы прогнали той же процедурой. С той самой оферты текст и начинается.
Лонгрид читается минут за пять.
❤1👍1
БизнесМатика
Как устроена Svaya и где проходят границы ее самостоятельности
Этот раздел отвечает на вопрос, что платформа Svaya делает сама, что за нее решает человек и как это проверить по записям запусков и на стенде. Описания выгод…
ИИ-платформа Svaya получила 5 баллов из 6 по методике оценки агентности консалтинговой компании «Яков и Партнёры».
Каждый третий российский поставщик ИИ-решений называет свой продукт ИИ-помощником или ИИ-агентом (таких 34% по данным «Якова и Партнёров»), при этом хорошо понимают, что такое ИИ-агент, только 11% людей вне ИИ-отрасли.
Летом 2026 года «Яков и Партнёры» выпустили отчёт «ИИ-агенты: где хайп, а где реальность» и предложили проверять продукты по 6 критериям: агентный цикл, планирование, работа с инструментами, самокоррекция, память и автономное завершение задачи. Методика подсчета такова, что за ответ «да» по критерию дается 1 балл, за «частично» дается 0,5 балла.
Авторы прошли по открытым источникам 12 публичных российских ИИ-продуктов, но не смогли найти полноценных ИИ-агентов. По их данным, вот лучшие результаты у ИИ-платформ для построения агентов:
Yandex AI Studio: 5,5 из 6
GigaChat Enterprise от «Сбера»: 5,0
Agent Platform от Just AI: 5,0
MWS AI Agents Platform от МТС: 4,5.
Мы самостоятельно проделали работу по нашей ИИ-платформе Svaya - прошли по тем же 6 критериям сами и получили оценку 5 из 6. По сумме наш счёт вровень с GigaChat Enterprise и Just AI, выше MWS и ниже Yandex AI Studio. По правилу отчёта 4 «да» дают категорию «агент с ограничениями», полноценный агент начинается с 5 «да». Платформам отчёт ставит отдельный вердикт, «Платформа для сборки агентов», и оговаривает, что этот порог платформа может проходить как элемент инфраструктуры, но готовым бизнес-агентом сама по себе не становится. Svaya - это платформа в том же смысле, и вердикт подходит нам. Отличие в том, кто собирает решения под процессы заказчика. У четвёрки, по отчёту, это сами клиенты, на Svaya собираем мы.
Методика меряет по открытым источникам, то есть по тому, что поставщик о себе написал, и наши 5 баллов стоят на том же.
Что с этими баллами делать покупателю платформы? Проверять коробочных «агентов» по 6 критериям, как советует отчёт, и с этим мы согласны. Попросите у поставщика ещё и запись прогона, где видны проходы цикла, вызовы систем, исправление негодного ответа и отметка человека на точке подтверждения. У нас всё это в сумме видно на двух карточках витрины (карточки товаров и ответ по кредитной заявке). Записи сделаны на нашем стенде на синтетических данных.
❤1👍1🤔1
На Хабре вышла моя статья, на этот раз инженерная. Два месяца наш внутренний LLM-конвейер читает ленты четырнадцати закупочных площадок, снимает лишнее дешёвой моделью, качает документацию, собирает ТЗ и оценивает закупку по 18 критериям. Человек решает на гейте, в какую закупку следует идти. За это время 4 452 карточки, 23 заявки и 253 записи в журнале разработки, большинство про то, как оно ломалось)
Главное наблюдение неожиданное - промпты скоринга и предскоринга почти не менялись, по сути всё время ушло на доработку кода вокруг LLM. В статье расписаны места, где ломался именно этот код, с числами из трассы: поиск в чужом индексе, который не находит слово из названия; регулярка, где «ПО» совпадало с предлогом «по»; третий вердикт «сомнительно»; отказ LLM, записанный как «критерий пройден»; подвал площадки и иероглиф вместо ТЗ; реестр собственных пропусков.
Статья на Хабре.
❤1🤝1
БизнесМатика
Svaya и Landev AI: ИИ-платформы расходятся в том, когда фиксируется порядок действий ИИ
Мы в БизнесМатике составили анкету из 8 вопросов, которые следует задать вендору корпоративной ИИ-платформы, а также подготовили ответы на эти вопросы для двух…
Мы в БизнесМатике составили 8 вопросов, которые стоит задать вендору ИИ-платформы до первой встречи, и ответили на них за две платформы сразу, за свою ИИ-платформу Svaya и за Landev AI группы компаний ЛАНИТ, по публичным страницам обеих платформ. Сегодня эта анкета вышла на сайте. Она продолжает статью от 3 сентября, где мы изучали страницы Landev AI, и пост от 8 сентября о том, как мы насчитали Svaya 5 баллов из 6 по критериям агентности из отчёта консалтинговой компании «Яков и Партнёры» 2026 года.
Главное расхождение между двумя платформами нашлось в вопросе, что известно о поведении ИИ до первого запуска. Страница ИИ-агентов на сайте Landev AI описывает агентов, которые сами «формируют пошаговую стратегию» и при этом «Соблюдают ваши правила» (права доступа, compliance, регуляторику), и зовёт читателя собирать их в конструкторе агентов без кода. У Svaya порядок шагов задачи записывает человек (автор описания задачи) до установки платформы у заказчика, платформа проверяет его при установке, и во время прогона (одного исполнения задачи) он остаётся прежним. Самостоятельность у LLM в Svaya есть внутри шага одного вида, агентского, где она сама выбирает, какие инструменты (обращения к системам заказчика и внешним источникам) вызвать и в каком порядке.
Наша позиция такая, потому что там, где ошибка ИИ стоит денег или объяснений регулятору, порядок шагов, зафиксированный до установки, важнее стратегии, которую агент строит на ходу, потому что такой порядок можно показать аудитору до первого запуска. Там, где закон не требует остановки ИИ на решение человека и задача меняется каждую неделю, агент из конструктора даст результат быстрее, чем продукт с порядком шагов, записанным до установки, а про скорость сборки Landev AI обещает, что LanDev AI «помогает быстро создавать, изменять и масштабировать агентов».
Все 8 вопросов и ответы за обе платформы на сайте.
❤1👍1
БизнесМатика
Как считается объём, ниже которого мы не берёмся за LLM-пилот, и почему наш первый порог оказался завышен в 2,5 раза
Наша команда внедряет языковые модели в прикладные задачи заказчиков, и в июле 2026 года мы посчитали экономику одиннадцати пилотов. Среди них карточки товаров…
На сайте вышла моя статья про то, как считается порог отказа, объём, ниже которого мы не предлагаем LLM-пилот, и как наше первое такое число оказалось завышено в 2,5 раза.
В июле мы посчитали одиннадцать пилотов и в каждом расчёте записали порог. 8 августа при проверке перед публикацией лонгрида порог для карточек товаров не пережил пересчёта. Стояло 38 250 позиций каталога, действующий расчёт даёт 15 150. Причина оказалась в лестнице лицензии, ступени которой меряются карточками в месяц, а порог считался при ступени, которой у каталога такого размера не бывает. В тот же день пересчитали четыре числа из десяти опубликованных, два из них стояли ниже собственного правила окупаемости.
В статье разобран сам расчёт: правило четырёх месяцев, из которого выводится порог; какую половину расчёта заказчик считает сам, а какую обязан назвать подрядчик; четыре ловушки, из-за которых чужое число нельзя брать по аналогии, от ступеней лицензии до вопроса, что вы сделаете с высвобожденным временем; и один вопрос подрядчику до сметы, по которому за минуту видно, считал ли кто-нибудь вашу задачу.
Статья целиком на сайте.
❤1👍1
БизнесМатика
Какую LLM развернуть on-premise под 152-ФЗ. Что требует закон, что решает железо и почему LLM должна быть сменяемой
Вопрос «какую LLM развернуть on-premise, чтобы соблюсти 152-ФЗ и не отдавать данные в облако» задают нам на пресейлах и задают поисковикам. Вопрос содержит…
Вопрос «какую LLM развернуть on-premise, чтобы соблюсти 152-ФЗ» задают нам на пресейлах, и вопрос содержит ошибку. 152-ФЗ не требует своего сервера. Он требует хранить базы персональных данных граждан России в стране, уведомить Роскомнадзор и отвечать за утечку деньгами, с 30 мая 2025 года до 15 млн ₽ за первую и от 1% до 3% выручки за повторную. Слов «on-premise» и «запрещено облако» в законе нет.
В свой контур компанию ведут другие причины, то есть адвокатская, аудиторская, банковская или коммерческая тайна, у каждой из которых своя статья, и статус значимого объекта КИИ у госоргана или заказчика по 223-ФЗ, где с 2025 года запрещено иностранное ПО. А выбор самой LLM ограничивают недоступность OpenAI и Anthropic из России и закон 243-ФЗ, который с марта 2027 года даст Правительству право в отдельных случаях требовать только суверенные или национальные LLM.
Поэтому «какую LLM» это третий вопрос по счёту. Сначала, какие данные попадают в промпт. Потом, какое железо есть или будет куплено, потому что объём видеопамяти задаёт класс LLM жёстче любого бенчмарка. И только потом, как менять LLM, потому что за два года её сменит регулятор, вендор или новое поколение открытых LLM.
Сегодня разбор вышел на сайте. В нём четыре способа развернуть LLM с именами (ПАК Сбера, Яндекса и MWS AI, открытые Qwen, DeepSeek, GigaChat3, T-pro и gpt-oss с лицензиями), таблица «что помещается в карту 24, 80 ГБ и в узел из восьми карт» с ценами Cloud.ru и одного поставщика серверов, позиции открытых LLM на русском бенчмарке MERA Text 2.0 и то, как в нашей платформе Svaya LLM сделана сменяемым компонентом.
❤1👍1
БизнесМатика
Корпоративная база знаний на основе RAG, который команда ИТ-Телеком развернула почти полностью своими руками
ИТ-Телеком строит ИТ-инфраструктуру, в компании до тридцати человек. Её технический руководитель был поисковой системой этой компании. К нему приходило по…
Две недели назад мы выложили кейс ИТ-Телекома про корпоративную базу знаний на основе RAG. Компания строит ИТ-инфраструктуру, архив объектов у неё жил в головах двух-трёх человек, и тех. руководителю приходило по 5-10 вопросов в день; чаще всего они сводились к «а где такое уже делали и чем тогда комплектовали?». Сейчас приходит 1-2.
Часть вопросов до этого уходила публичным ИИ-чат-ботам вместе с рабочими документами. Риск в компании понимали, она сама строит ИТ-инфраструктуру, но быстрого способа получить ответ иначе не было; про теневой ИИ на личных телефонах мы писали в июле.
Схема поставки была нашей обычной: годовая лицензия на ИИ-платформу Svaya, установку разворачивала команда клиента, от нас консультации и проверка на контрольных точках.
Кейс целиком на сайте, с числами, с тем, чего мы не проверяли, и с тем, что у клиента пока не работает.
❤1👍1
БизнесМатика
С чего начать LLM-проект в юридической, аудиторской, консалтинговой компании или кадровом агентстве. Три класса документов, три…
Я перечитал раздел нашего каталога LLM-задач про юридические компании, аудиторские и финансово-консалтинговые компании, стратегических консультантов и кадровые…
На сайте bm-it.ru вышла моя статья о том, с чего начинать LLM-проект в юридической, аудиторской, консалтинговой компании или кадровом агентстве, и почему у юристов дёшево не выходит даже на собственных методичках.
Я перечитал раздел нашего каталога LLM-задач (с ним мы ходим на первые встречи) по этим отраслям, семь задач с бюджетами, и проверил простую гипотезу, что цену первого проекта делает то, чьи документы попадут в LLM-систему, свои или клиентские. Подтвердилось наполовину. Клиентские документы, по подписям строк бюджета, удорожают одну задачу из семи. А юридическим и аудиторским компаниям каталог ставит на арендованный сервер даже поиск по собственным методичкам, 3-8 млн ₽ против 1,5-4 млн ₽ на облачном API у стратегических консультантов и кадровых агентств за тот же поиск по нормативной базе и методичкам. На облачном API у юристов и аудиторов по каталогу только регуляторный мониторинг и черновик предложений по архиву.
В статье три класса документов и один гибрид, таблица трёх цен одной задачи, где цену делает сервер и где обезличивание позволяет остаться в облаке, почему протоколирование встреч закрывается подпиской без подрядчика (об этом мы писали в августе) и два вопроса, которые стоит задать подрядчику до архитектуры и до агентов. Первый из них - это вопрос, какого класса документы попадут в систему и можно ли для пилота обойтись обезличенными.
Статья целиком на сайте.
❤1👍1
БизнесМатика
Механизм маскирования перс. данных можно протестировать на svaya.bm-it.ru. Зачем проверять то же самое у других поставщиков ИИ…
У нас есть продукт - ИИ-платформа Svaya, у неё есть витрина на svaya.bm-it.ru, там можно вживую прогнать 30 прикладных задач с LLM для разных отраслей, в том…
Политика обработки данных нашей витрины Svaya обещает искать в загруженных файлах «фамилии и имена, телефоны, адреса, реквизиты» и маскировать найденное перед отправкой в языковую модель. Я собрал короткую выдуманную справку о контрагенте и проверил это обещание по пунктам.
Механизм нашёл почту, телефон, паспорт, ИНН и два имени. Открытыми ушли оба адреса, расчётный счёт, корреспондентский счёт, БИК, СНИЛС и кадастровый номер. Тогда я собрал второй файл, в котором нет ничего, кроме восьми обыкновенных адресов. Нашлось ноль из восьми.
У этого есть готовый ответ, и он стоит в той же политике следующим предложением. «Поиск может пропустить непривычную запись, полноту оператор не гарантирует». Оговорка правильная, и такая должна быть у всех. Но восемь обыкновенных адресов подряд непривычной записью не назовёшь, и причина лежит внутри. Внутри шесть правил, и правила адреса среди них нет вовсе.
Разница принципиальная. Одно дело, когда механизм ищет и иногда промахивается. Другое, когда он эту категорию не ищет совсем, и оговорка про качество поиска такого не закрывает.
Проверяется это у любого поставщика за пятнадцать минут. Приносите на демонстрацию короткий выдуманный документ с тремя или четырьмя обыкновенными адресами и просите показать сам маскированный текст, тот, который уходит в языковую модель. Смотреть надо на него. Ответ языковой модели вам тут ничего не скажет. Не показывают текст, просите перечень найденных категорий с числом замен и сверяйте числа с тем, что положили сами. Не показывают ничего, вы уже получили ответ.
В сегодняшнем лонгриде разбираю весь опыт целиком. Что именно лежало в файлах, что механизм нашёл, почему имена пропускаются по форме записи и какие три вопроса стоит задать поставщику ИИ-платформы на демо.
❤1👍1
БизнесМатика
Как посчитать окупаемость внедрения ИИ в бизнес-процесс. И почему новые задачи из-за ИИ уменьшают экономию, пока не посчитана польза…
В августе консалтинговая компания McKinsey выпустила ежегодный отчёт о применении ИИ в бизнесе. В нем раскрыто очень интересное противоречие: с одной стороны…
В августе вышел ежегодный отчёт консалтинговой компании McKinsey о применении ИИ в бизнесе. 80% опрошенных, которые используют ИИ в работе, говорят, что ИИ поднял их личную продуктивность, а хотя бы минимальный вклад ИИ в операционную прибыль своей компании видят только 37% опрошенных. Дело в том, что личную продуктивность люди оценивают самостоятельно, а прибыль считает бухгалтерия, и расчет окупаемости ИИ должен связать первое со вторым.
В статье разобран приём, которым министерство бизнеса и торговли Великобритании оценивало пилот Microsoft 365 Copilot, ИИ-помощника в офисных программах Microsoft. Участники пилота записывали в дневник, сколько каждая задача заняла с Copilot, оценивали, сколько заняла бы без него, и отмечали, воспользовались ли результатом Copilot и стали бы вообще делать эту задачу без него. Из сэкономленного времени аналитики министерства вычли время на задачи, которые без Copilot никто бы не делал, и на результаты Copilot, которыми потом не воспользовались. В задачах по анализу данных экономия времени на одну задачу после этих вычетов упала с 2 часов до 0,6 часа. В задачах по генерации изображений экономия стала отрицательной, с 1,5 часа до минус 0,5 часа.
Ещё в статье мы привели формулу срока окупаемости и пути, которыми сэкономленное время сотрудников превращается в деньги. В конце статьи есть вопросы, которые руководитель должен задать подрядчику или своей команде, когда речь заходит о расчете окупаемости ИИ, самый важный из которых - а сколько времени сотрудники потратили на задачи, которые без ИИ никто бы не делал, и посчитано ли отдельно, какую пользу эти задачи приносят.
Статья целиком на сайте.
❤1👍1
БизнесМатика
Рекомендации Банка России № 3-МР по защите информации при применении ИИ: какие проверки банк может ввести у себя?
16 июня 2026 года Банк России выпустил методические рекомендации № 3-МР о защите информации при разработке и применении искусственного интеллекта (ИИ)…
16 июня 2026 года Банк России выпустил методические рекомендации № 3-МР о защите информации при разработке и применении ИИ финансовыми организациями. Мы прочитали рекомендации целиком, чтобы выяснить, что они предлагают банку, если внешний поставщик обновит ИИ-модель, на которой работает процесс банка (например, раскладка обращений клиентов по темам). Рекомендации описывают проверку безопасности поставщика и советуют следить за поведением ИИ-модели. Как заметить обновление ИИ-модели у сервиса поставщика, в рекомендациях не поясняется.
Поводом задать вопрос об обновлении ИИ-модели у поставщика стала статья «Коммерсанта» от 12 июля, в которой Тимур Аитов, председатель комиссии по финансовой безопасности совета Торгово-промышленной палаты России, описал сценарий, при котором сбой у поставщика или «незаметное изменение параметров на стороне поставщика» приводит к тому, что участники рынка сокращают лимиты (какие именно лимиты и чьи, статья не уточняет). Слова Аитова о незаметном изменении параметров мы толкуем как обновление ИИ-модели у поставщика.
Что после обновления ИИ-модели ответы могут измениться, показало исследование Стэнфордского университета и Калифорнийского университета в Беркли. У мартовской версии GPT-4 (LLM компании OpenAI) 2023 года просьба рассуждать по шагам поднимала долю верных ответов на вопросах о простых и составных числах с 59,6% до 84,0%. У июньской версии просьба рассуждать по шагам почти не меняла долю верных ответов (51,0% без неё и 51,1% с ней). Запрос к ИИ-модели, составленный для одной версии, может перестать работать на следующей. Исследование касается зарубежных LLM 2023 года. Замеров по LLM российских поставщиков среди использованных нами материалов нет.
В нашей статье на сайте БизнесМатики разобраны проверки, которые банк может ввести у себя, чтобы заметить обновление ИИ-модели у поставщика и подготовиться к нему. Первая проверка - это контрольный набор, то есть реальные обращения или документы банка с заранее известными правильными ответами. Контрольный набор по расписанию отправляется в ИИ-модель, а доля верных ответов сравнивается с результатом предыдущей отправки. Кроме контрольного набора, в статье разобраны такие проверки:
- запись о том, какая ИИ-модель какой версии работает в процессе, где она влияет на решение банка (например, на выбор темы обращения клиента) или на действие с деньгами клиента, и вопрос поставщику, может ли версия измениться без согласия банка;
- возможное условие в договоре, по которому поставщик заранее сообщает об изменении версии ИИ-модели;
- пробная замена на запасную ИИ-модель.
Мы считаем, что начинать стоит с контрольного набора. Эта проверка не требует согласия поставщика и для задач с проверяемым ответом показывает на вошедших в набор случаях изменение доли верных ответов независимо от того, кто и когда обновил ИИ-модель. Опыта применения этих проверок в банках в статье нет, они выведены из рекомендаций № 3-МР, других документов Банка России и исследования.
Статья целиком на сайте.
👍1
БизнесМатика
Как сравнивать расходы на токены ИИ-моделей с зарплатой сотрудника. И сколько в рублях токены добавляют к стоимости разных должностей
12 августа Билайн рассказал о своей внутренней ИИ-платформе «Экзоинтеллект», к которой с апреля подключились около 10 тысяч сотрудников компании. Среди…
12 августа Билайн рассказал о своей ИИ-платформе для сотрудников «Экзоинтеллект». Среди вопросов, которые Билайн прорабатывает с появлением цифровых ИИ-сотрудников, в объявлении названы вопросы «штатного расписания и интеграции фонда оплаты труда со стоимостью токенов». Осенью компании собирают бюджеты на 2027 год, и вопрос о том, как сравнивать расходы на нейросети с зарплатой сотрудников, встаёт у каждой компании, которая уже платит за ИИ.
Месячный счёт за токены с месячной зарплатой сравнивать нельзя. Средний российский сотрудник вместе со страховыми взносами по общему тарифу обходится компании примерно в 149 тысяч рублей в месяц, а тысяча токенов GigaChat Max, ИИ-модели Сбера, стоит юридическому лицу 0,65 рубля с НДС. Если сравнить месяц работы офисного сотрудника с месячным счётом за токены, ИИ окажется дешевле в десятки и сотни раз. Но ИИ делает только часть работы сотрудника, и ещё часть своего времени сотрудник тратит на то, чтобы поставить задачу ИИ и проверить результат.
В статье мы посчитали в рублях, сколько токены российских ИИ-моделей добавляют к стоимости сотрудника на пяти должностях, по оценке расхода токенов на типовых задачах. У помощника руководителя токены добавляют к стоимости сотрудника 0,3-0,4%, у юриста 1,8-2,2%. У части программистов, которые работают с ИИ-агентами, расход на токены бывает сопоставим с зарплатой. По данным аналитической компании Jellyfish за первый квартал 2026 года, у 20% разработчиков с самым высоким расходом на токены расход примерно в 600 раз выше, чем у 20% с самым низким, а принятых изменений в коде только примерно вдвое больше.
Расход на ИИ удобнее держать в управленческом бюджете при подразделении и должности, рядом со строкой фонда оплаты труда, а там, где расход большой, связывать его с результатом работы. В конце статьи пять вопросов, которые руководитель должен задать, когда ему приносят расчёт «агент дешевле сотрудника». Первый вопрос о том, сколько стоит один принятый результат с учётом времени сотрудника на постановку задачи, проверку и исправления. С этого вопроса статья советует начинать, потому что без ответа на него остальные расчёты строятся на мнении.
Статья целиком на сайте.
❤1